
Los modelos de lenguaje grandes pueden ayudar a las aplicaciones a responder preguntas, resumir documentos, generar contenido y asistir con la programación. Una API de LLM ofrece a los desarrolladores una forma programática de acceder a estas capacidades e incorporarlas a sus flujos de trabajo de software. Esta guía explica cómo funcionan las API de LLM, qué considerar al elegir una y cómo Kimi API puede respaldar tu aplicación.
Qué es una API de LLM
Una API de LLM (API de modelo de lenguaje grande) es una interfaz que permite a las aplicaciones acceder programáticamente a las capacidades de los modelos de lenguaje grandes. Actúa como un puente entre una aplicación y un modelo de IA, lo que permite a los desarrolladores enviar prompts, configurar parámetros compatibles y recibir respuestas generadas por el modelo.
Por ejemplo, una plataforma de atención al cliente puede usar una API de LLM para responder las preguntas de los clientes, mientras que un sistema de gestión de contenido puede integrarla para resumir artículos o generar descripciones de productos.
Según el modelo, una API de LLM puede admitir generación de texto, preguntas y respuestas, resúmenes, traducción, generación de código, análisis de documentos y conversaciones de varios turnos. Algunos servicios también admiten entradas multimodales, como imágenes. Una clave de API de LLM autentica las solicitudes al servicio del proveedor.
Conceptos básicos de una API de LLM
Al trabajar con una API de LLM, encontrarás cuatro conceptos básicos: solicitudes, respuestas, endpoints y autenticación. Comprender cómo funcionan te ayudará a comenzar con la integración de API.
Una puerta de enlace de API de LLM se sitúa entre una aplicación y los servicios de modelos, y puede ofrecer funciones como enrutamiento, registro, limitación de velocidad, almacenamiento en caché y respaldo.
Solicitud: Una solicitud es el mensaje que tu aplicación envía al servicio de LLM. Normalmente contiene un prompt, junto con parámetros que controlan cómo el modelo genera su respuesta, como la selección del modelo o la longitud máxima de salida.
Respuesta: Una respuesta son los datos que devuelve el servicio de LLM después de procesar una solicitud. Por lo general, incluye el texto generado, además de información como el estado de la solicitud, el uso de token u otros metadatos.
Endpoint: Un endpoint es la URL específica a la que tu aplicación envía solicitudes de API. Los proveedores de LLM pueden ofrecer distintos endpoints para tareas como generación de texto, embeddings u otras capacidades del modelo.
Autenticación: La autenticación verifica que tu aplicación esté autorizada para acceder a la API. La mayoría de los servicios de LLM utilizan una clave de API, una credencial única que identifica tu aplicación y ayuda al proveedor a administrar el acceso y realizar un seguimiento del uso. Por lo general, obtienes esta clave a través de la plataforma para desarrolladores del proveedor.
Estos cuatro conceptos trabajan juntos en una interacción típica de API: tu aplicación se autentica con una clave de API, envía una solicitud al endpoint adecuado y recibe una respuesta del servicio de LLM. Este proceso básico es la base para integrar modelos de lenguaje en las aplicaciones.
Cómo funciona una API de LLM
Una API de LLM conecta una aplicación con un modelo de lenguaje mediante un proceso de solicitud y respuesta. La aplicación envía una entrada a un endpoint de API, el modelo procesa la solicitud y la API devuelve la respuesta generada.
El proceso normalmente consta de cinco pasos:
Obtener acceso a la API: Regístrate con un proveedor de API y genera una clave de API. Esta clave autentica las solicitudes y debe almacenarse de forma segura en el lado del servidor.
Preparar y enviar una solicitud: La aplicación envía una solicitud al endpoint de API, generalmente mediante HTTP y JSON. Por lo general, incluye el modelo seleccionado, el prompt del usuario o los mensajes de la conversación y parámetros opcionales, como la temperatura y el número máximo de tokens de salida.
Procesar la entrada: La API valida la solicitud y la reenvía al LLM seleccionado. El modelo interpreta el prompt y utiliza el contexto proporcionado para generar una respuesta relevante.
Generar y devolver la respuesta: La API devuelve la salida del modelo, generalmente en formato JSON. Las respuestas pueden entregarse completas de una sola vez o transmitirse de forma incremental a medida que el modelo genera contenido.
Usar la salida: La aplicación extrae el contenido generado y lo utiliza según su propósito, por ejemplo, para mostrar respuestas de un chatbot, resumir documentos o almacenar información extraída.
Por qué usar una API de LLM
Una API de LLM ofrece a los desarrolladores una forma consistente de conectar modelos de lenguaje a los flujos de trabajo de las aplicaciones, lo que facilita la creación de funciones como chatbots, herramientas de resumen y asistentes de programación.
Integra IA en aplicaciones existentes: Conecta modelos de lenguaje a sitios web, apps móviles y sistemas empresariales para agregar funciones como chatbots, búsqueda inteligente y generación de contenido.
Automatiza tareas repetitivas: Automatiza tareas como responder preguntas frecuentes, resumir documentos, extraer información y clasificar comentarios de clientes.
Personaliza las interacciones de IA: Usa prompts, contexto y parámetros de generación para controlar el tono, el formato y el contenido de las respuestas según los requisitos de la aplicación.
Respalda el crecimiento de la aplicación: Integra capacidades de IA en distintos flujos de trabajo y ajusta el uso de la API según cambien las demandas de la aplicación, sujeto a los límites y la capacidad del proveedor.
Reduce los requisitos de infraestructura: Accede a modelos de lenguaje alojados sin gestionar el entrenamiento de modelos, hardware especializado ni la infraestructura de inferencia subyacente.
Accede a capacidades de LLM para tus aplicaciones: Kimi API
Si buscas una API de LLM para integrar capacidades de modelos de lenguaje en tu aplicación, Kimi API ofrece una plataforma orientada a desarrolladores basada en los modelos de lenguaje de gran tamaño desarrollados por Moonshot AI, con opciones flexibles para crear fácilmente herramientas, aplicaciones y flujos de trabajo impulsados por IA.
Ofrece diversas capacidades para crear aplicaciones impulsadas por IA, como generación de texto, conversaciones de múltiples turnos, análisis de archivos y búsqueda web. La plataforma también es compatible con el formato de OpenAI API, lo que ayuda a los desarrolladores a integrar modelos Kimi en aplicaciones existentes con menos esfuerzo de migración.
Funciones principales
Varios modelos para distintas necesidades de desarrollo: Kimi API ofrece varios modelos de lenguaje con diferentes capacidades y perfiles de rendimiento, lo que permite a los desarrolladores elegir según los requisitos de su aplicación. Ya sea que desarrollen asistentes de IA, herramientas de programación o aplicaciones de procesamiento de documentos, pueden seleccionar un modelo adecuado para sus cargas de trabajo. Por ejemplo, kimi-k3-1-pro admite razonamiento complejo, programación de largo alcance y trabajo de conocimiento.
Procesamiento de contexto extenso para tareas complejas: kimi-k3-1-pro admite una ventana de contexto de hasta un millón de tokens, lo que permite a las aplicaciones procesar documentos extensos, conversaciones largas y grandes volúmenes de información de referencia. Esta capacidad es útil para el análisis de documentos, los flujos de trabajo intensivos en conocimiento y las tareas que requieren mantener el contexto en varios pasos.
Compatibilidad con el formato de OpenAI API: Kimi API es compatible con el formato de OpenAI API, lo que facilita a los desarrolladores integrar modelos Kimi en aplicaciones existentes. Los desarrolladores familiarizados con las estructuras de solicitudes compatibles con OpenAI pueden adaptar sus integraciones de API existentes con menos cambios de código, siempre que verifiquen los parámetros específicos del modelo y la compatibilidad de las funciones.
Respuestas en streaming y sin streaming: Kimi API admite respuestas en streaming y sin streaming mediante su interfaz Chat Completions. El streaming entrega el contenido generado de forma incremental, por lo que es adecuado para aplicaciones interactivas como los chatbots. Sin streaming, se devuelve la respuesta completa de una vez, lo cual funciona bien para tareas como la generación de contenido y el resumen de documentos.
Precios según el uso y almacenamiento en caché del contexto: Kimi API utiliza precios según el uso; los cargos por inferencia de modelos varían según el modelo e incluyen tokens de entrada, tokens de salida y las tarifas aplicables de escritura en caché. El almacenamiento en caché del contexto puede reducir los costos de entrada cuando se reutilizan prefijos de solicitud repetidos durante el período de validez de la caché. El ahorro real depende de la cantidad de contenido repetido, los aciertos de caché y la duración de la caché. La búsqueda web y otras herramientas pueden generar cargos por separado. Consulta la documentación oficial de precios para conocer las tarifas y los detalles de facturación actuales.
Cómo obtener una clave de Kimi API
Comenzar a usar Kimi API es sencillo, y lo primero que necesitas es una clave de API para conectar tu aplicación con los modelos de Moonshot AI. Sigue estos pasos para crear tu cuenta y obtener tu clave de Kimi API:
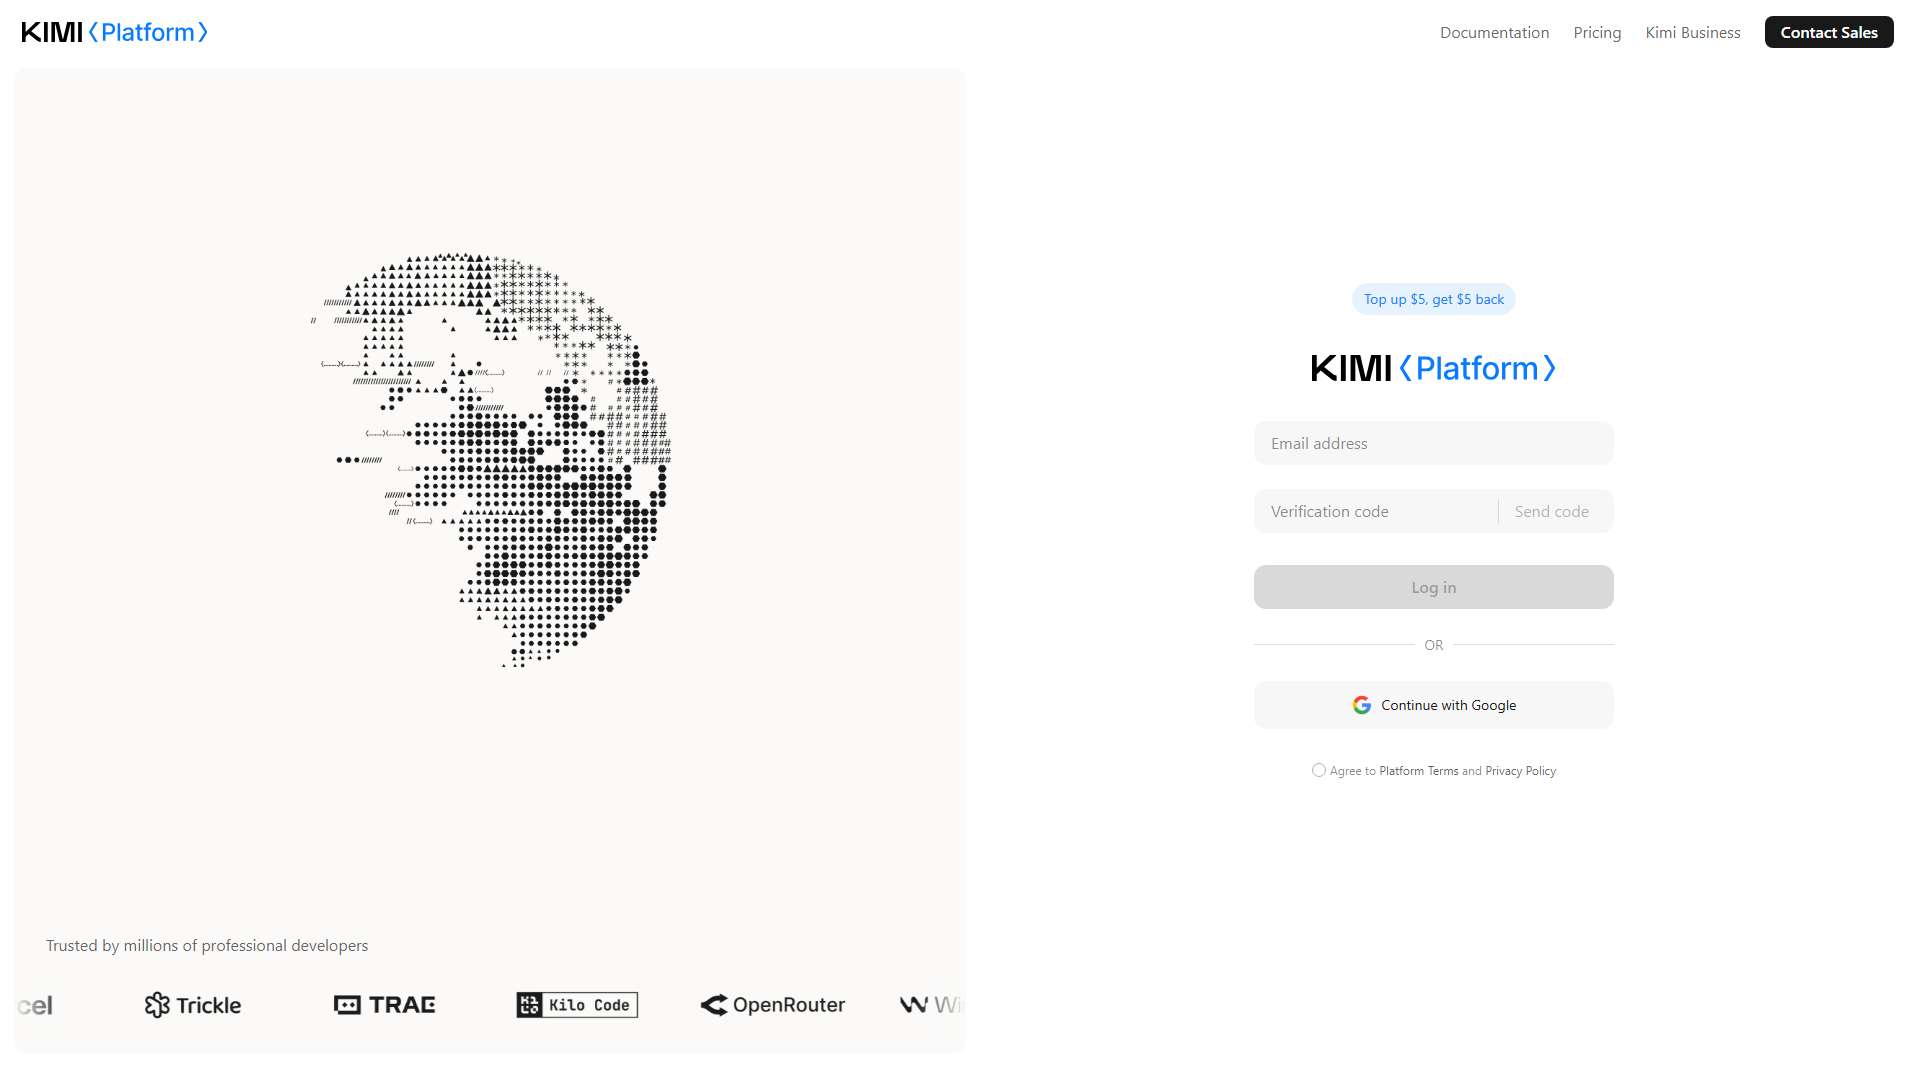
Paso 1. Crea una cuenta de desarrollador
Visita la plataforma de Kimi API y regístrate para obtener una cuenta de desarrollador. Inicia sesión para acceder a la consola de API, donde puedes administrar tus claves de API, uso y facturación.
Paso 2. Genera una clave de API
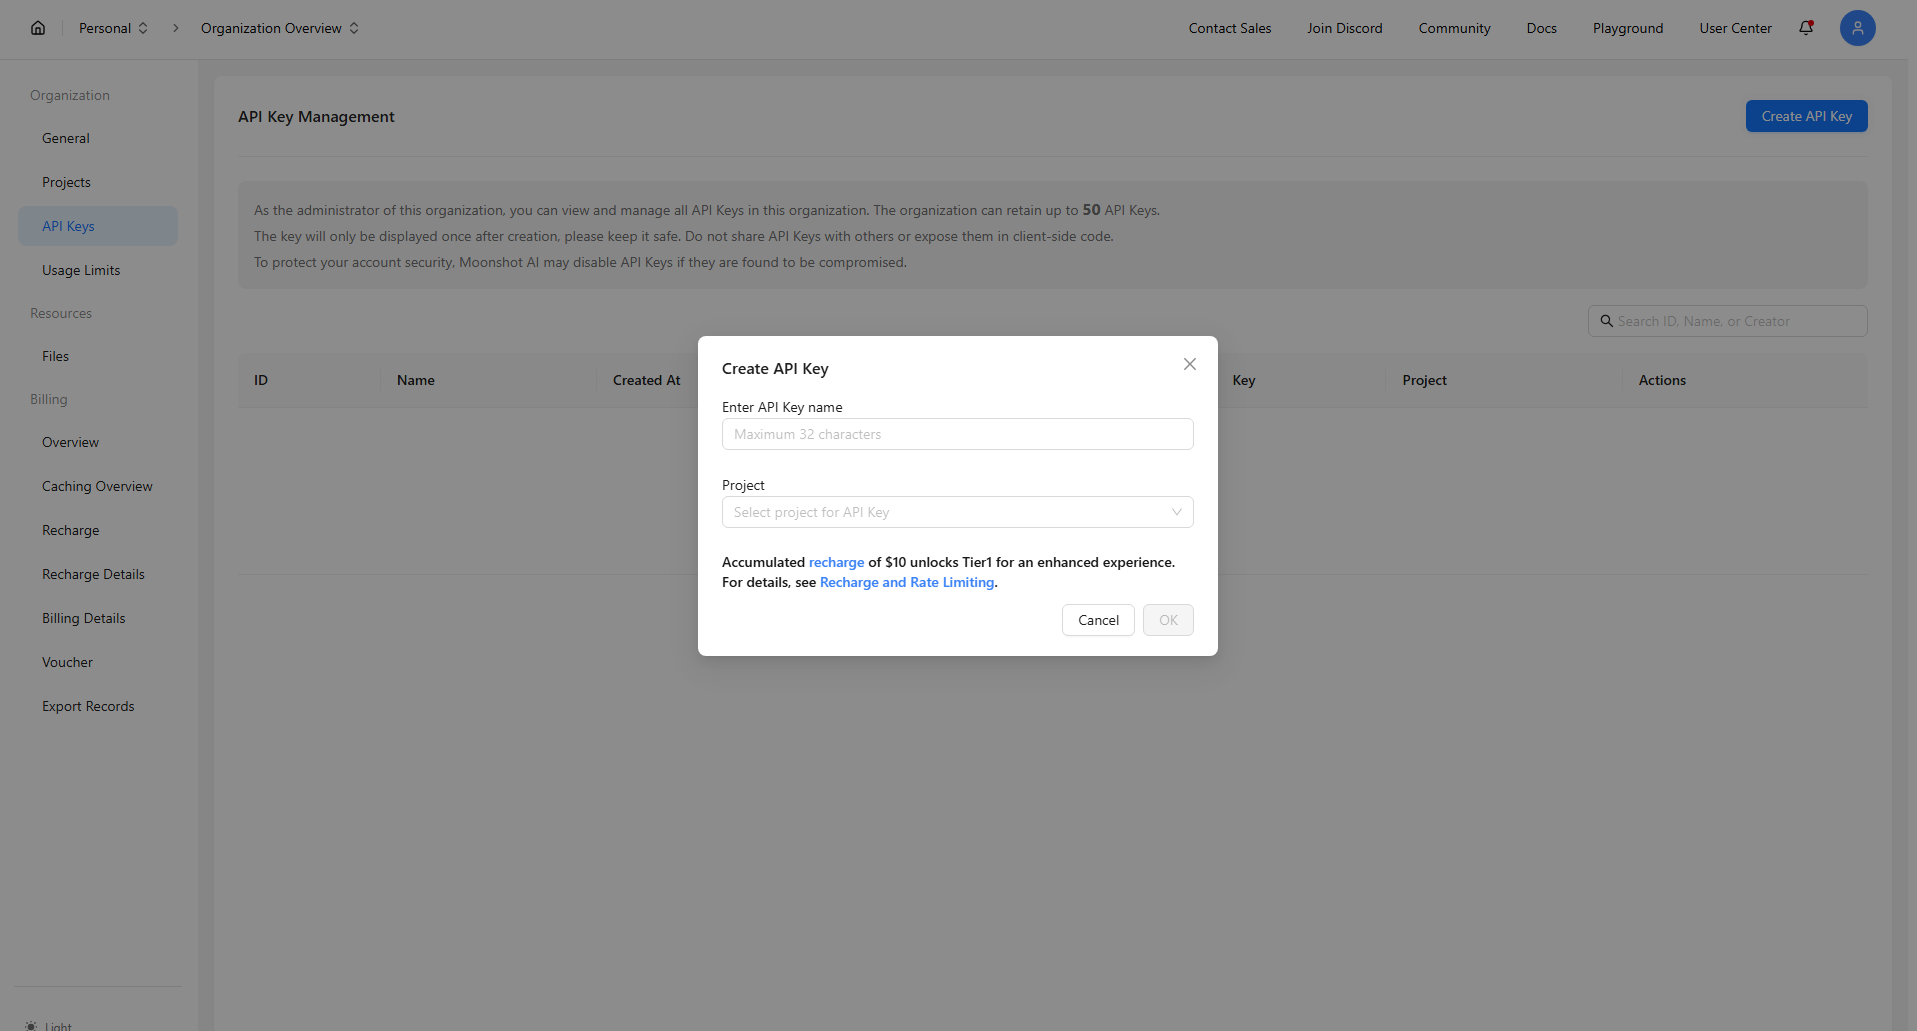
Abre la sección de administración de claves de API en la consola y haz clic en "Create API Key". Ingresa un nombre para identificar tu clave, confirma su creación y copia la clave generada. Guárdala de forma segura, ya que es posible que no puedas volver a ver la clave completa.
Mantén segura tu clave de API. Guárdala en una variable de entorno del lado del servidor o en un administrador de secretos, y nunca la expongas en repositorios públicos ni en código del lado del cliente.
Paso 3. Prepara la configuración de tu API
Antes de realizar una llamada a la API, prepara los siguientes datos:
Clave de API: La clave generada en el paso 2.
URL base:
https://api.moonshot.ai/v1Modelo: El ID del modelo Kimi que deseas usar.
Kimi API admite el formato Chat Completions compatible con OpenAI, por lo que puedes usar SDK compatibles para enviar solicitudes.
Paso 4. Realiza tu primera llamada a la API
Instala el SDK de OpenAI para Python:
Configura tu clave de Kimi API como la variable de entorno KIMI_API_KEY. Por ejemplo, usa el siguiente comando en tu terminal:
Para macOS o Linux
Para Windows PowerShell
A continuación, crea un script de Python llamado first_kimi_call.py con el siguiente código:
Reemplaza kimi-k3-1-pro por un ID de modelo Kimi válido. Luego, ejecuta el script:
El script envía una solicitud de finalización de chat a Kimi API. Si la solicitud se realiza correctamente y devuelve una respuesta, tu integración con Kimi API está funcionando. Ahora puedes modificar el prompt, cambiar de modelo e incorporar funciones impulsadas por API en tu aplicación.
Qué buscar en un proveedor unificado de API de LLM
Un proveedor unificado de API de LLM puede simplificar la integración de modelos al ofrecer una interfaz consistente para acceder a modelos de IA. Sin embargo, la compatibilidad de la API por sí sola no determina si un proveedor es adecuado para tu aplicación. Al evaluar un proveedor de API de LLM, considera los siguientes factores:
Compatibilidad con SDK de OpenAI: Una interfaz compatible con OpenAI permite a los desarrolladores reutilizar SDK y patrones de integración conocidos mediante la configuración del endpoint de la API y el ID del modelo del proveedor. Verifique qué endpoints, parámetros y funciones son compatibles para conocer el alcance de la compatibilidad.
Cobertura de modelos y proveedores: Considere la variedad de modelos y proveedores disponibles. Una selección más amplia de modelos brinda a los desarrolladores mayor flexibilidad para probar distintas capacidades, comparar el rendimiento y elegir modelos para cargas de trabajo específicas.
Visibilidad del uso y los costos: Busque formas de supervisar las solicitudes a la API, el consumo de token y los costos de uso. El seguimiento por modelo o por solicitud puede ayudar a los desarrolladores a comprender los patrones de gasto y administrar los presupuestos de las aplicaciones.
Caché y rendimiento: El almacenamiento en caché de respuestas puede reducir las solicitudes repetidas y mejorar los tiempos de respuesta para entradas recurrentes. Al evaluar el rendimiento de la API, considere también la compatibilidad con streaming, la latencia y los límites de velocidad.
Confiabilidad y opciones de respaldo: Revise cómo el proveedor gestiona los errores, las interrupciones temporales del servicio y los límites de velocidad. Los mecanismos de reintento y las opciones de respaldo pueden ayudar a mantener la disponibilidad de la aplicación cuando un modelo o endpoint deja de estar disponible.
Observabilidad y control de implementación: Los registros de solicitudes, las métricas de rendimiento y el rastreo pueden ayudar a los desarrolladores a solucionar problemas de la API y evaluar el comportamiento del modelo. Para aplicaciones con requisitos específicos de infraestructura o datos, considere también las opciones de implementación y las políticas de gestión de datos.
El proveedor adecuado depende de los requisitos técnicos de su aplicación, el uso previsto y las prioridades operativas. Para los desarrolladores que ya planean usar modelos Kimi, Kimi API ofrece una interfaz compatible con OpenAI para integrar modelos compatibles en aplicaciones existentes. Puede configurar el endpoint de la API y el ID del modelo para comenzar.
Casos de uso comunes de las API de LLM
Las API de LLM admiten una amplia variedad de aplicaciones al permitir que el software comprenda, genere y procese lenguaje natural. Algunos casos de uso comunes incluyen:
Chatbots de IA y atención al cliente: Integre LLM en chatbots para comprender las preguntas de los clientes y generar respuestas pertinentes. Las empresas pueden usarlos para responder preguntas frecuentes, proporcionar información sobre productos, ayudar a solucionar problemas y atender consultas de clientes.
Generación de contenido y asistencia de redacción: Use API de LLM para generar descripciones de productos, textos de marketing, campañas de correo electrónico y publicaciones para redes sociales. Las aplicaciones de escritura también pueden integrarlas para reescribir párrafos, corregir la gramática, ajustar el tono y resumir contenido extenso.
Procesamiento de documentos y extracción de datos: Procese información no estructurada de contratos, informes y documentos empresariales. Las API de LLM pueden ayudar a extraer detalles clave, identificar cláusulas importantes, categorizar contenido y generar resúmenes concisos, lo que reduce la revisión manual de documentos.
Asistentes de programación con IA: Integre modelos de lenguaje en herramientas de desarrollo para generar código a partir de instrucciones en lenguaje natural, explicar código existente, identificar posibles errores y sugerir correcciones. También pueden ayudar a redactar pruebas unitarias y documentación técnica.
Búsqueda semántica y recuperación de conocimiento: Cree aplicaciones de búsqueda que comprendan el significado y el contexto de las consultas de los usuarios, en lugar de depender únicamente de coincidencias exactas de palabras clave. Combinadas con embeddings y sistemas de recuperación, las API de LLM pueden ayudar a los usuarios a encontrar información relevante en documentos y bases de conocimiento de la empresa.
Traducción y localización: Integre API de LLM en flujos de trabajo de traducción para procesar contenido de sitios web, descripciones de productos y comunicaciones empresariales en varios idiomas. Las instrucciones contextuales y las pautas terminológicas pueden ayudar a mantener mensajes coherentes para distintos mercados.
Conclusión
Elegir la API de LLM adecuada depende de las necesidades de su aplicación, la complejidad de sus tareas y su presupuesto. Una buena API debe facilitar la integración de IA y, al mismo tiempo, ofrecer suficiente flexibilidad para desarrollar y mejorar su aplicación con el tiempo. Vale la pena explorar Kimi API si busca una plataforma flexible con distintos modelos y funciones pensadas para desarrolladores.




