Deux agents peuvent utiliser exactement le même modèle et obtenir des scores très différents sur un même benchmark. OpenAI l'a mesuré directement : sur SWE-bench Lite, GPT-4 a obtenu 2,7 % avec un harnais et 28,3 % avec un autre — un écart d'un facteur 10 entièrement créé par le harnais. Alors que le secteur est passé de « quel modèle est le plus intelligent ? » à « quel agent accomplit réellement le travail ? », le harnais d'agent est devenu la couche où se joue la fiabilité. Poursuivez votre lecture pour découvrir ce qu'est un harnais d'agent, ce que disent les articles et benchmarks les plus récents sur la conception des harnais, quels harnais open source méritent votre attention et comment les principaux laboratoires d'IA conçoivent les leurs — notamment Kimi K3.1 Pro, le modèle à poids ouverts que Moonshot AI associe à ses propres harnais.
Qu'est-ce qu'un harnais d'agent ?
Un harnais d'agent est l'infrastructure qui permet à un grand modèle de langage d'opérer comme un agent dans un environnement réel. Là où le modèle produit des tokens, le harnais s'occupe de tout le reste : il construit le prompt à chaque étape, définit les outils disponibles et leur mode d'appel, exécute les actions dans un bac à sable ou un terminal, renvoie les observations au modèle, impose des limites d'étapes et de coûts, et journalise la trajectoire complète pour l'évaluation ou le débogage.
Le terme vient du monde de l'évaluation : un « test harness » est le dispositif qui exécute un système dans des conditions contrôlées. Dans l'IA agentique, cette idée a été étendue à la production : un harnais est à la fois le dispositif servant à mesurer un agent (comme dans SWE-bench ou Terminal-Bench) et celui servant à exécuter un agent (comme dans SWE-agent, OpenHands ou Claude Code).
Les propres recherches d'Anthropic sur SWE-bench l'expriment clairement : le benchmark « n'évalue pas seulement le modèle d'IA de manière isolée, mais un système d'“agent” dans son ensemble », où l'agent est « la combinaison d'un modèle d'IA et de l'infrastructure logicielle qui l'entoure ». Leur Claude 3.5 Sonnet amélioré a atteint 49 % sur SWE-bench Verified non pas avec un framework complexe, mais avec un harnais minimal composé d'un prompt et de deux outils généralistes (un outil Bash et un outil Edit).
Pourquoi le harnais compte autant que le modèle
Pendant des années, les progrès dans les classements ont été attribués à l'échelle des modèles. Les recherches récentes ont remis cette hypothèse en cause de deux manières.
Premier résultat, « moins, c'est mieux » : en juillet 2025, l'équipe de SWE-bench a publié mini-SWE-agent, un harnais d'environ 100 lignes de Python sans autres outils que bash, avec un historique de messages entièrement linéaire et chaque action exécutée comme un appel subprocess.run indépendant. Il a atteint des scores de benchmark compétitifs face à des frameworks bien plus complexes (voir la section consacrée à la recherche ci-dessous). La leçon était provocatrice : une fois le modèle suffisamment performant, un harnais extrêmement simple et prévisible peut surpasser un harnais lourd. Il est déjà utilisé comme référence par Meta, NVIDIA, IBM, Princeton et Stanford.
Second résultat, « plus, c'est moins » : un mauvais harnais — sorties d'outils bruitées, boucles sans limite, mauvaise récupération après erreur — peut faire paraître médiocre un modèle de pointe. OpenAI a constaté que le nettoyage des tâches défectueuses de SWE-bench (détaillé dans la section OpenAI ci-dessous) a plus que doublé les performances mesurées des modèles.
C'est pourquoi l'ingénierie des harnais est devenue une discipline à part entière. Le harnais détermine :
Ce que voit le modèle : la structure du prompt, les schémas d'outils, ainsi que la quantité de l'état de l'environnement et de l'historique incluse dans la fenêtre de contexte.
Ce que peut faire le modèle : les outils disponibles (shell, éditeur de fichiers, navigateur, recherche), et la manière dont les actions sont analysées et validées avant leur exécution.
La gestion des échecs : les relances, les délais d'expiration, la compaction du contexte lorsque la fenêtre se remplit, et l'arrêt propre.
La mesure du travail : la journalisation des trajectoires, l'évaluation et le suivi des coûts — sans lesquels il n'y a ni évaluation ni boucle d'amélioration.
L'anatomie d'un harnais d'agent
Qu'il s'agisse d'un dispositif de benchmark de recherche ou d'un assistant de programmation en production, presque tous les harnais d'agent mettent en œuvre la même boucle fondamentale :
Réception de la tâche : lire le ticket, l'instruction ou l'objectif, et démarrer un environnement isolé (généralement un conteneur Docker ou un instantané de VM).
Assemblage du prompt : combiner le prompt système, les définitions d'outils, la description de la tâche et l'historique en cours des actions et observations.
Analyse des actions : traduire la sortie du modèle en un appel d'outil concret — une commande bash, une modification de fichier, une requête API — et rejeter les actions mal formées.
Exécution et observation : exécuter l'action dans l'environnement, capturer stdout/stderr ou l'état de l'interface, puis le tronquer pour respecter le budget de contexte.
Flux de contrôle : appliquer des limites d'étapes et de coût, ainsi que des conditions d'arrêt ; décider quand solliciter un humain ou mettre fin à l'épisode.
Enregistrement et évaluation : sauvegarder la trajectoire complète et évaluer l'état final — par exemple, en exécutant la suite de tests du dépôt dans SWE-bench.
Les choix de conception à chaque étape se cumulent. À elle seule, la stratégie de troncature peut faire varier sensiblement les scores sur les tâches à long horizon ; c'est pourquoi les équipes sérieuses considèrent l'infrastructure d'exécution comme un logiciel versionné et testable, et non comme du simple code de liaison.
Dernières recherches : ce que disent réellement les publications
La littérature universitaire sur les infrastructures d'exécution d'agents a convergé vers un petit nombre de conclusions durement acquises. Plutôt que de répertorier chaque benchmark, cette section retrace les questions de recherche qui ont contraint le domaine à prendre cette infrastructure au sérieux.
Les benchmarks en bref : ce qu'ils sont, comment ils mesurent, comment les interpréter
Avant d'aborder les publications, voici quelques notions de base. Un benchmark est un ensemble fixe de tâches assorti d'une règle de notation, conçu pour comparer différents systèmes dans des conditions identiques. Dans l'évaluation d'agents, un benchmark comporte trois éléments variables : un ensemble de tâches (de véritables tickets GitHub, des commandes de terminal, des tâches web), un environnement d'exécution (un conteneur Docker, un navigateur, un terminal) et un évaluateur (une suite de tests, une vérification d'état, une revue humaine). L'infrastructure d'exécution se situe entre le modèle et ces trois éléments : c'est elle qui détermine si les capacités du modèle se reflètent dans le score.
La manière dont les scores sont réellement mesurés compte davantage que le chiffre mis en avant. Dans SWE-bench, un agent produit un correctif de code ; le benchmark exécute ensuite deux suites de tests : FAIL_TO_PASS (des tests qui échouaient avant le correctif et doivent désormais réussir) et PASS_TO_PASS (des tests qui fonctionnaient avant et ne doivent pas échouer). La tâche n'est considérée comme résolue que si les deux réussissent. C'est pourquoi des fonctions d'infrastructure telles que l'exécution des tests et la génération de diff ne sont pas des options superflues : c'est là que les points se gagnent ou se perdent.
Trois règles pour interpréter n'importe quel score de benchmark :
Demandez-vous ce que le score masque. Un modèle entraîné sur des données GitHub publiques peut avoir déjà vu les tickets mêmes sur lesquels il est testé : la contamination des données peut gonfler les scores sans véritable gain de capacité. Des environnements reproductibles et des ensembles de tâches réservés constituent le remède.
Méfiez-vous de la loi de Goodhart : lorsqu'une mesure devient un objectif, elle cesse d'être une bonne mesure. Une infrastructure réglée pour exceller sur un benchmark peut apprendre des astuces propres à ce benchmark plutôt qu'une capacité générale ; c'est pourquoi les équipes sérieuses en évaluent plusieurs.
Examinez l'infrastructure, pas seulement le modèle. Comme le montre le reste de cette section, le même modèle peut obtenir 2,7 % ou 28,3 % selon l'infrastructure qui l'accompagne. Un score sans infrastructure nommée est une anecdote, pas une mesure.
SWE-bench : le benchmark qui a révélé le problème de l'infrastructure
La publication originelle sur SWE-bench ("Can Language Models Resolve Real-World GitHub Issues?") a introduit l'évaluation désormais canonique : donner à un modèle un véritable ticket GitHub et le dépôt complet, puis vérifier si son correctif permet aux tests défaillants de réussir. Son résultat le plus cité est souvent mal interprété : le meilleur modèle de l'époque, Claude 2, n'a résolu que 1,96 % des tâches. Les auteurs expliquaient eux-mêmes que le benchmark testait un « raisonnement complexe qui va bien au-delà de la génération de code traditionnelle » ; mais les travaux ultérieurs ont montré qu'une grande part de l'écart ne relevait pas de la capacité de raisonnement, mais de l'absence d'une infrastructure capable de parcourir un dépôt, d'exécuter des tests et d'itérer. Autrement dit, SWE-bench n'a pas seulement mesuré les modèles ; il a révélé que l'infrastructure qui les entoure était la pièce manquante.
SWE-agent : la publication qui a nommé l'infrastructure
La publication sur SWE-agent ("Agent-Computer Interfaces Enable Automated Software Engineering") est le texte fondateur du domaine en matière de conception d'infrastructure d'exécution. Son idée centrale est que la conception de l'interface est une variable de premier ordre : les auteurs ont introduit le terme Agent-Computer Interface (ACI) et montré qu'une interface conçue à cet effet — un éditeur de fichiers encadré par un linter, des retours shell concis, des garde-fous contre les commandes mal formées — faisait passer le pass@1 sur SWE-bench de quelques faibles pourcents à 12,5 %, un record à l'époque. L'apport durable de cette publication est l'idée que les « agents LM constituent une nouvelle catégorie d'utilisateurs finaux » qui ont besoin de logiciels conçus pour eux, tout comme les humains ont besoin d'IDE. Toutes les publications ultérieures sur les infrastructures citent ce résultat.
OSWorld et WebArena : l'infrastructure quitte le terminal
Deux publications de 2024 ont étendu la recherche sur les infrastructures d'exécution, des dépôts de code à l'ordinateur dans son ensemble. OSWorld a créé le premier environnement informatique réel et extensible couvrant Ubuntu, Windows et macOS, avec 369 tâches réparties entre applications web et de bureau. Son chiffre phare — les humains accomplissent 72,36 % des tâches, contre 12,24 % pour le meilleur modèle — a identifié le calage sur l'interface graphique (la traduction de la sortie du modèle en clics et frappes corrects) comme le principal mode d'échec : un problème d'infrastructure, non de connaissances. WebArena a adopté une autre approche : un environnement web auto-hébergé et entièrement reproductible (e-commerce, forums, GitLab, CMS), dans lequel GPT-4 n'a atteint que 14,41 % de réussite de bout en bout, contre 78,24 % pour les humains. Ces deux publications ont établi que l'évaluation des infrastructures doit être fondée sur l'exécution (en vérifiant l'état final de l'environnement), et non sur une correspondance de motifs dans les sorties des modèles.
τ-bench : l'utilisateur fait partie de l'infrastructure
Le τ-bench de Sierra ("A Benchmark for Tool-Agent-User Interaction in Real-World Domains") a soulevé un point plus subtil : en production, l'infrastructure n'encadre pas seulement le modèle et l'environnement, elle assure aussi la médiation avec l'utilisateur. Le benchmark simule des conversations dynamiques entre un utilisateur fondé sur un modèle de langage et un agent disposant d'API de domaine et de directives de politique, puis évalue l'état final de la base de données. Sa métrique clé, pass^k (la réussite sur k essais indépendants), a mis en évidence l'inconstance des agents : GPT-4o a résolu moins de 50 % des tâches lors d'un seul essai, et le pass^8 est tombé sous les 25 % dans le commerce de détail. Pour les concepteurs d'infrastructures, la leçon est que la fiabilité est une propriété distributionnelle, et non une propriété d'une seule exécution : une infrastructure qui fonctionne une fois n'est pas une infrastructure qui fonctionne.
METR : l'infrastructure doit évoluer avec le modèle
La publication de METR, "Measuring AI Ability to Complete Long Software Tasks", a introduit l'horizon temporel de réalisation de 50 % des tâches : la durée d'une tâche (mesurée par son temps de réalisation humain) qu'un modèle achève avec une fiabilité de 50 %. Entre 2019 et 2025, les modèles de pointe sont passés de quelques minutes à environ une heure, doublant approximativement tous les sept mois. Pour l'ingénierie des infrastructures d'exécution, c'est la conclusion la plus déterminante de la décennie : l'infrastructure qui contraint un modèle de 2024 devient un poids mort pour un modèle de 2026. Selon Anthropic, chaque composant d'une infrastructure repose sur une hypothèse quant à ce que le modèle ne peut pas faire — et ces hypothèses deviennent obsolètes à mesure que les modèles progressent.
La famille SWE-bench aujourd'hui
Le benchmark d'origine est devenu un écosystème qui met ces enseignements en pratique :
SWE-bench Verified (avec OpenAI, 2024) : un sous-ensemble de 500 instances filtrées par des humains, qui a retiré les tâches insuffisamment spécifiées ou évaluées de façon inéquitable — 68,3 % du corpus initial ont été écartés, ce qui a plus que doublé les scores mesurés et en a fait le classement de référence.
SWE-smith (2025) : un pipeline de génération de tâches d'entraînement synthétiques, afin d'entraîner les modèles aux infrastructures agentiques plutôt que de simplement les y évaluer.
mini-SWE-agent (2025) : l'infrastructure d'environ 100 lignes qui dépasse désormais 74 % sur SWE-bench Verified, démontrant qu'une boucle minimale utilisant uniquement bash avec un historique linéaire suffit lorsque le modèle est performant — et qui devient la référence par défaut de la communauté.
Terminal-Bench (Stanford × Laude, 2025) : une évaluation de tâches de terminal fondée sur le framework Harbor, qui étend les infrastructures au-delà de la modification de code vers l'administration système.
CodeClash (2025) et ProgramBench (2026) : création de logiciels orientée objectifs et à partir de zéro, étendant les infrastructures des corrections de tickets isolés au développement ouvert.
Le fil conducteur de tous ces travaux est constant : l'infrastructure n'est pas de la plomberie, c'est l'objet de l'étude. Indiquez l'infrastructure avec le score, veillez à ce que l'environnement soit reproductible et méfiez-vous de tout résultat dont l'infrastructure ne peut pas être inspectée.
Infrastructures d'exécution d'agents open source populaires
Les infrastructures open source sont le point de départ de la plupart des équipes. Les projets ci-dessous associent de vastes communautés GitHub (des dizaines de milliers d'étoiles pour les principaux) à une maintenance active :
| Projet | Objectif | Ce qui le distingue |
|---|---|---|
DeepSeek Harness (dsh) | Infrastructure d'exécution d'agents fondée sur des plugins | Le nouvel arrivant et l'un de ceux qui connaissent la croissance la plus rapide : plus de 170 k étoiles quelques mois après sa sortie. Conçu par DeepSeek AI sur le framework Cordis, avec une architecture où « tout est un plugin » — l'adaptateur de modèle, le registre d'outils, le journal de session et la boucle de l'agent sont tous des plugins interchangeables —, c'est la concrétisation open source la plus proche du concept de « méta-infrastructure » (une infrastructure conçue pour survivre à toute implémentation d'infrastructure particulière, comme expliqué dans la section Anthropic ci-dessous). |
| OpenClaw | Passerelle multi-agents | Un framework open source qui fait office de passerelle pour gérer plusieurs agents, avec un routage multi-agents natif et un écosystème de plugins mature. Son architecture est plus complexe que celle des infrastructures à agent unique, mais il excelle dans l’orchestration de workflows entre agents spécialisés. |
| Hermes Agent | Agent personnel auto-améliorant | Un agent IA open source et auto-améliorant de Nous Research, doté d’une mémoire persistante et d’un système de compétences intégré. Il apprend des interactions avec les utilisateurs, développe ses propres capacités au fil du temps et s’exécute localement avec la prise en charge de plusieurs modèles et plateformes de messagerie. |
| OpenHands (anciennement OpenDevin) | Agents de développement logiciel full-stack | L’un des projets d’agent les plus populaires sur GitHub ; il est devenu un centre de contrôle « Agent Canvas » capable d’exécuter OpenHands, Claude Code, Codex ou Gemini sur des backends locaux, Docker, VM et cloud via l’Agent-Client Protocol (ACP). |
| SWE-agent | Infrastructure d’agent de programmation de niveau recherche | L’implémentation de référence de l’Agent-Computer Interface ; simple, modifiable et référence à laquelle la plupart des articles se comparent. Les mainteneurs orientent désormais la plupart des utilisateurs vers mini-SWE-agent. |
| mini-SWE-agent | Infrastructure d’évaluation minimaliste | Environ 100 lignes de Python, aucun outil autre que bash, un historique entièrement linéaire ; la manière la plus rapide d’évaluer un modèle sur SWE-bench et un outil pédagogique pour comprendre ce qu’est fondamentalement une infrastructure. |
| Aider | Programmation en binôme dans le terminal | Une infrastructure CLI très populaire qui convertit les dépôts en contexte exploitable par les modèles et applique les modifications via git — une leçon magistrale de conception pragmatique d’infrastructure. |
| Inspect AI (UK AI Security Institute) | Framework d’infrastructure d’évaluation | Un framework général permettant de rédiger des évaluations d’agents avec sandboxing, notation et outils de transcription ; largement adopté pour les évaluations de sécurité. |
| OpenAI Evals / simple-evals | Registres d’évaluation | Des modèles d’infrastructure légers pour reproduire les résultats publiés des benchmarks. |
| AutoGen / Microsoft Agent Framework | Orchestration multi-agents | Des abstractions d’infrastructure pour les équipes d’agents, l’utilisation d’outils et les workflows avec intervention humaine. |
Pour choisir entre ces solutions, la règle empirique de la communauté est la suivante : utilisez l’infrastructure minimale qui permet d’exprimer votre tâche (la philosophie mini-SWE-agent), et n’ajoutez de la complexité que lorsqu’une défaillance mesurée l’exige. DeepSeek Harness se situe à l’opposé du spectre — une plateforme entièrement pilotée par plugins, destinée aux équipes qui souhaitent que chaque couche soit remplaçable — mais les deux partagent une même discipline : un journal de session durable, auquel on ajoute uniquement des entrées, comme source unique de vérité sur ce que le modèle a vu.
Comment les géants de la tech conçoivent les infrastructures d’agents
Les laboratoires de pointe considèrent l’ingénierie des infrastructures comme une propriété intellectuelle essentielle, et plusieurs ont publié leur approche avec un niveau de détail inhabituel.
Anthropic
Anthropic a publié la documentation publique la plus complète sur l’ingénierie des infrastructures, et son architecture — détaillée dans Building Effective Agents (2024), l’article sur l’infrastructure SWE-bench (2024) et Managed Agents (2026) — peut se lire comme trois couches concentriques.
La couche d’exécution est volontairement minimale : un outil Bash pour exécuter des commandes et un outil Edit pour consulter et modifier des fichiers. L’effort de conception a porté sur la fiabilité de ces outils — en exigeant des chemins absolus, en tronquant les sorties longues et en appliquant les modifications uniquement lorsqu’une chaîne correspond de manière unique — afin que le modèle ait rarement à se remettre de défaillances d’outils évitables.
La couche de session est un journal d’événements durable, auquel on ajoute uniquement des entrées, et qui se trouve en dehors de la fenêtre de contexte du modèle. Chaque action et chaque observation y sont enregistrées ; le contexte du modèle est une projection de ce journal, et non le journal lui-même. Cette séparation permet de redémarrer un processus d’infrastructure défaillant et de reprendre une tâche en cours, et fait de l’infrastructure du « bétail » jetable plutôt qu’un animal de compagnie.
La couche d’orchestration — qu’Anthropic appelle le « méta-harnais » — dissocie le « cerveau » (le modèle et sa boucle) des « mains » (les sandbox et les outils) au moyen d’interfaces explicites. Comme le cerveau ne réside plus dans le conteneur d’exécution, les sandbox peuvent être provisionnés à la demande et les identifiants peuvent être conservés dans un coffre-fort auquel le sandbox n’accède jamais. Le bénéfice rapporté est structurel, et non cosmétique : le délai p50 jusqu’au premier token a diminué d’environ 60 % et le p95 de plus de 90 %, car les sessions n’attendent plus des conteneurs qu’elles n’utiliseront peut-être jamais.
Trois documents retracent cette évolution : Building Effective Agents (2024), l’article sur l’infrastructure SWE-bench (2024) et Managed Agents (2026).
OpenAI
OpenAI s’est associé à l’équipe de SWE-bench pour créer le sous-ensemble Verified validé par des humains, précisément parce que les infrastructures ont besoin de tâches propres : leur campagne d’annotation (93 développeurs, 1 699 échantillons) a révélé que 68,3 % des tâches du benchmark d’origine étaient problématiques, et leur suppression a plus que doublé les performances mesurées. Le même article indique que le seul choix de l’infrastructure a fait passer GPT-4 de 2,7 % à 28,3 % sur SWE-bench Lite — un écart qu’ils citent pour défendre l’idée que les évaluations doivent tenir compte des progrès des infrastructures créées par la communauté.
Côté open source, le Codex CLI est fourni comme infrastructure de référence complète. Son architecture est organisée en couches, à l’image des autres systèmes de cette section : une boucle d’agent centrale gère la planification et les appels d’outils ; une couche de sandbox isole l’exécution avec une politique configurable pour chaque tâche ; une couche de session conserve les conversations afin de pouvoir les reprendre, les bifurquer ou les compacter ; et une couche d’outils donne accès au shell local ainsi qu’à des outils externes basés sur MCP. Plutôt que de figer une interface unique, le même moteur est exposé par trois interfaces — une interface utilisateur de terminal pour le travail interactif, un serveur d’application JSON-RPC pour les clients riches tels que VS Code, et un service distant d’exécution de code pour les sandbox cloud — afin que l’infrastructure puisse fonctionner localement ou être pilotée par programme. Cette conception applique les mêmes compromis que recommande la littérature de recherche : une boucle minimale, un sandbox robuste, une gestion explicite du contexte et une frontière nette entre le modèle et le monde extérieur.
Avec le Agent Development Kit (ADK) et le protocole Agent2Agent (A2A) — lancé en avril 2025 avec plus de 50 partenaires technologiques, dont Atlassian, Salesforce, SAP et ServiceNow — Google transforme la couche de harnais en produit. A2A standardise la manière dont les agents annoncent leurs capacités (via des « Agent Cards » JSON), gèrent les tâches de longue durée, échangent des artefacts et négocient les formats d’interface utilisateur, afin que les harnais deviennent une infrastructure interopérable plutôt qu’un assemblage sur mesure. Il est explicitement conçu pour compléter le Model Context Protocol (MCP) d’Anthropic, qui standardise la partie outils du harnais.
Microsoft et les autres
AutoGen et Magentic-One de Microsoft proposent des harnais dans lesquels un agent orchestrateur gère un registre des faits et de l’avancement — une conception publiée pour empêcher les boucles sans fin qui affectent les harnais naïfs. GAIA, de Meta et Hugging Face, a créé un benchmark d’assistant généraliste dont le harnais évalue des questions du monde réel nécessitant la navigation web et la manipulation de fichiers ; l’Open Agent Leaderboard de Hugging Face poursuit l’effort en faveur de classements comparables tenant compte des harnais.
DeepSeek
DeepSeek Harness (dsh) reprend l’idée du méta-harnais et la rend composable. Son architecture repose sur le framework Cordis et affirme un principe central : chaque composant du harnais est un plugin remplaçable — y compris l’adaptateur de modèle, le registre d’outils, le journal de session et la boucle de l’agent elle-même.
La conception repose sur trois primitives. Premièrement, un journal de session durable qui constitue la source de vérité unique sur ce que le modèle a vu ; tout ce qui parvient au modèle doit pouvoir être reconstruit à partir du journal, une contrainte imposée à l’exécution. Deuxièmement, des interfaces de capacité : une interface de fournisseur interchangeable entre l’agent et le monde extérieur, de sorte qu’orienter les fournisseurs de système de fichiers et de sous-processus vers un bac à sable distant y déplace aussi l’accès à Bash, au terminal et au serveur de langage, sans bifurquer le harnais. Troisièmement, un cycle de vie explicite des tours et des étapes avec des événements d’extension nommés (agent/pre-step, tools/execute, agent/turn-stopping) qui permettent aux plugins d’intercepter ou de réécrire la boucle sans modifier le code central.
Le résultat est la concrétisation open source la plus proche du méta-harnais d’Anthropic : un harnais dont la structure n’est pas un framework fixe, mais une composition de plugins interchangeables par configuration. Avec plus de 170 000 étoiles GitHub au cours de ses premiers mois, il indique que le harnais d’agent devient une catégorie de produit à part entière.
Le schéma commun à tous : garder une boucle simple, tout isoler en bac à sable, consigner chaque étape et ne jamais faire confiance à un score sans le harnais qui l’a produit.
Quand l’environnement dépasse la fenêtre de contexte
Tout ce qui précède dans cette section — les boucles minimales, les journaux de session durables, l’exécution en bac à sable, les architectures de plugins — repose sur une même hypothèse : l’environnement de l’agent est un ordinateur. Un terminal, un navigateur, un système de fichiers, un dépôt. Le harnais existe pour que l’agent puisse utiliser cette machine de manière fiable.
Mais la trajectoire de recherche décrite plus haut pointe ailleurs. τ-bench a placé l’utilisateur dans le harnais. METR a montré des agents capables de prendre en charge un travail qui s’étend sur des jours plutôt que des minutes. OSWorld et WebArena ont déplacé l’environnement d’un dépôt propre vers le monde réel, avec tout son désordre. La tendance est constante : à mesure que les agents passent d’outils de codage à de véritables assistants de travail, l’environnement qu’ils doivent parcourir ne se limite plus au silicium — il inclut les personnes. Des utilisateurs avec leurs attentes, des équipes avec leur histoire, des organisations avec leurs autorisations et leur savoir institutionnel.
Cette évolution touche avant tout un sous-système du harnais : la gestion du contexte. Une session de terminal n’a qu’un opérateur et un historique limité ; une collaboration de longue durée implique dix parties prenantes, des mois de décisions et un dépôt qui ne cesse de grossir. Un système de fichiers est passif ; une relation de travail est un flux d’engagements implicites, de pensées inachevées et de choix faits au passage. Tout cela doit être résumé, compacté ou écarté avant d’atteindre le modèle, et chacune de ces décisions est un point où l’agent perd quelque chose dont la tâche avait besoin.
Un harnais peut compresser, mais pas arbitrairement. C’est pourquoi la taille de la fenêtre de contexte a cessé d’être une spécification du modèle pour devenir un paramètre de conception du harnais.
Kimi : associer le harnais à Kimi K3.1 Pro
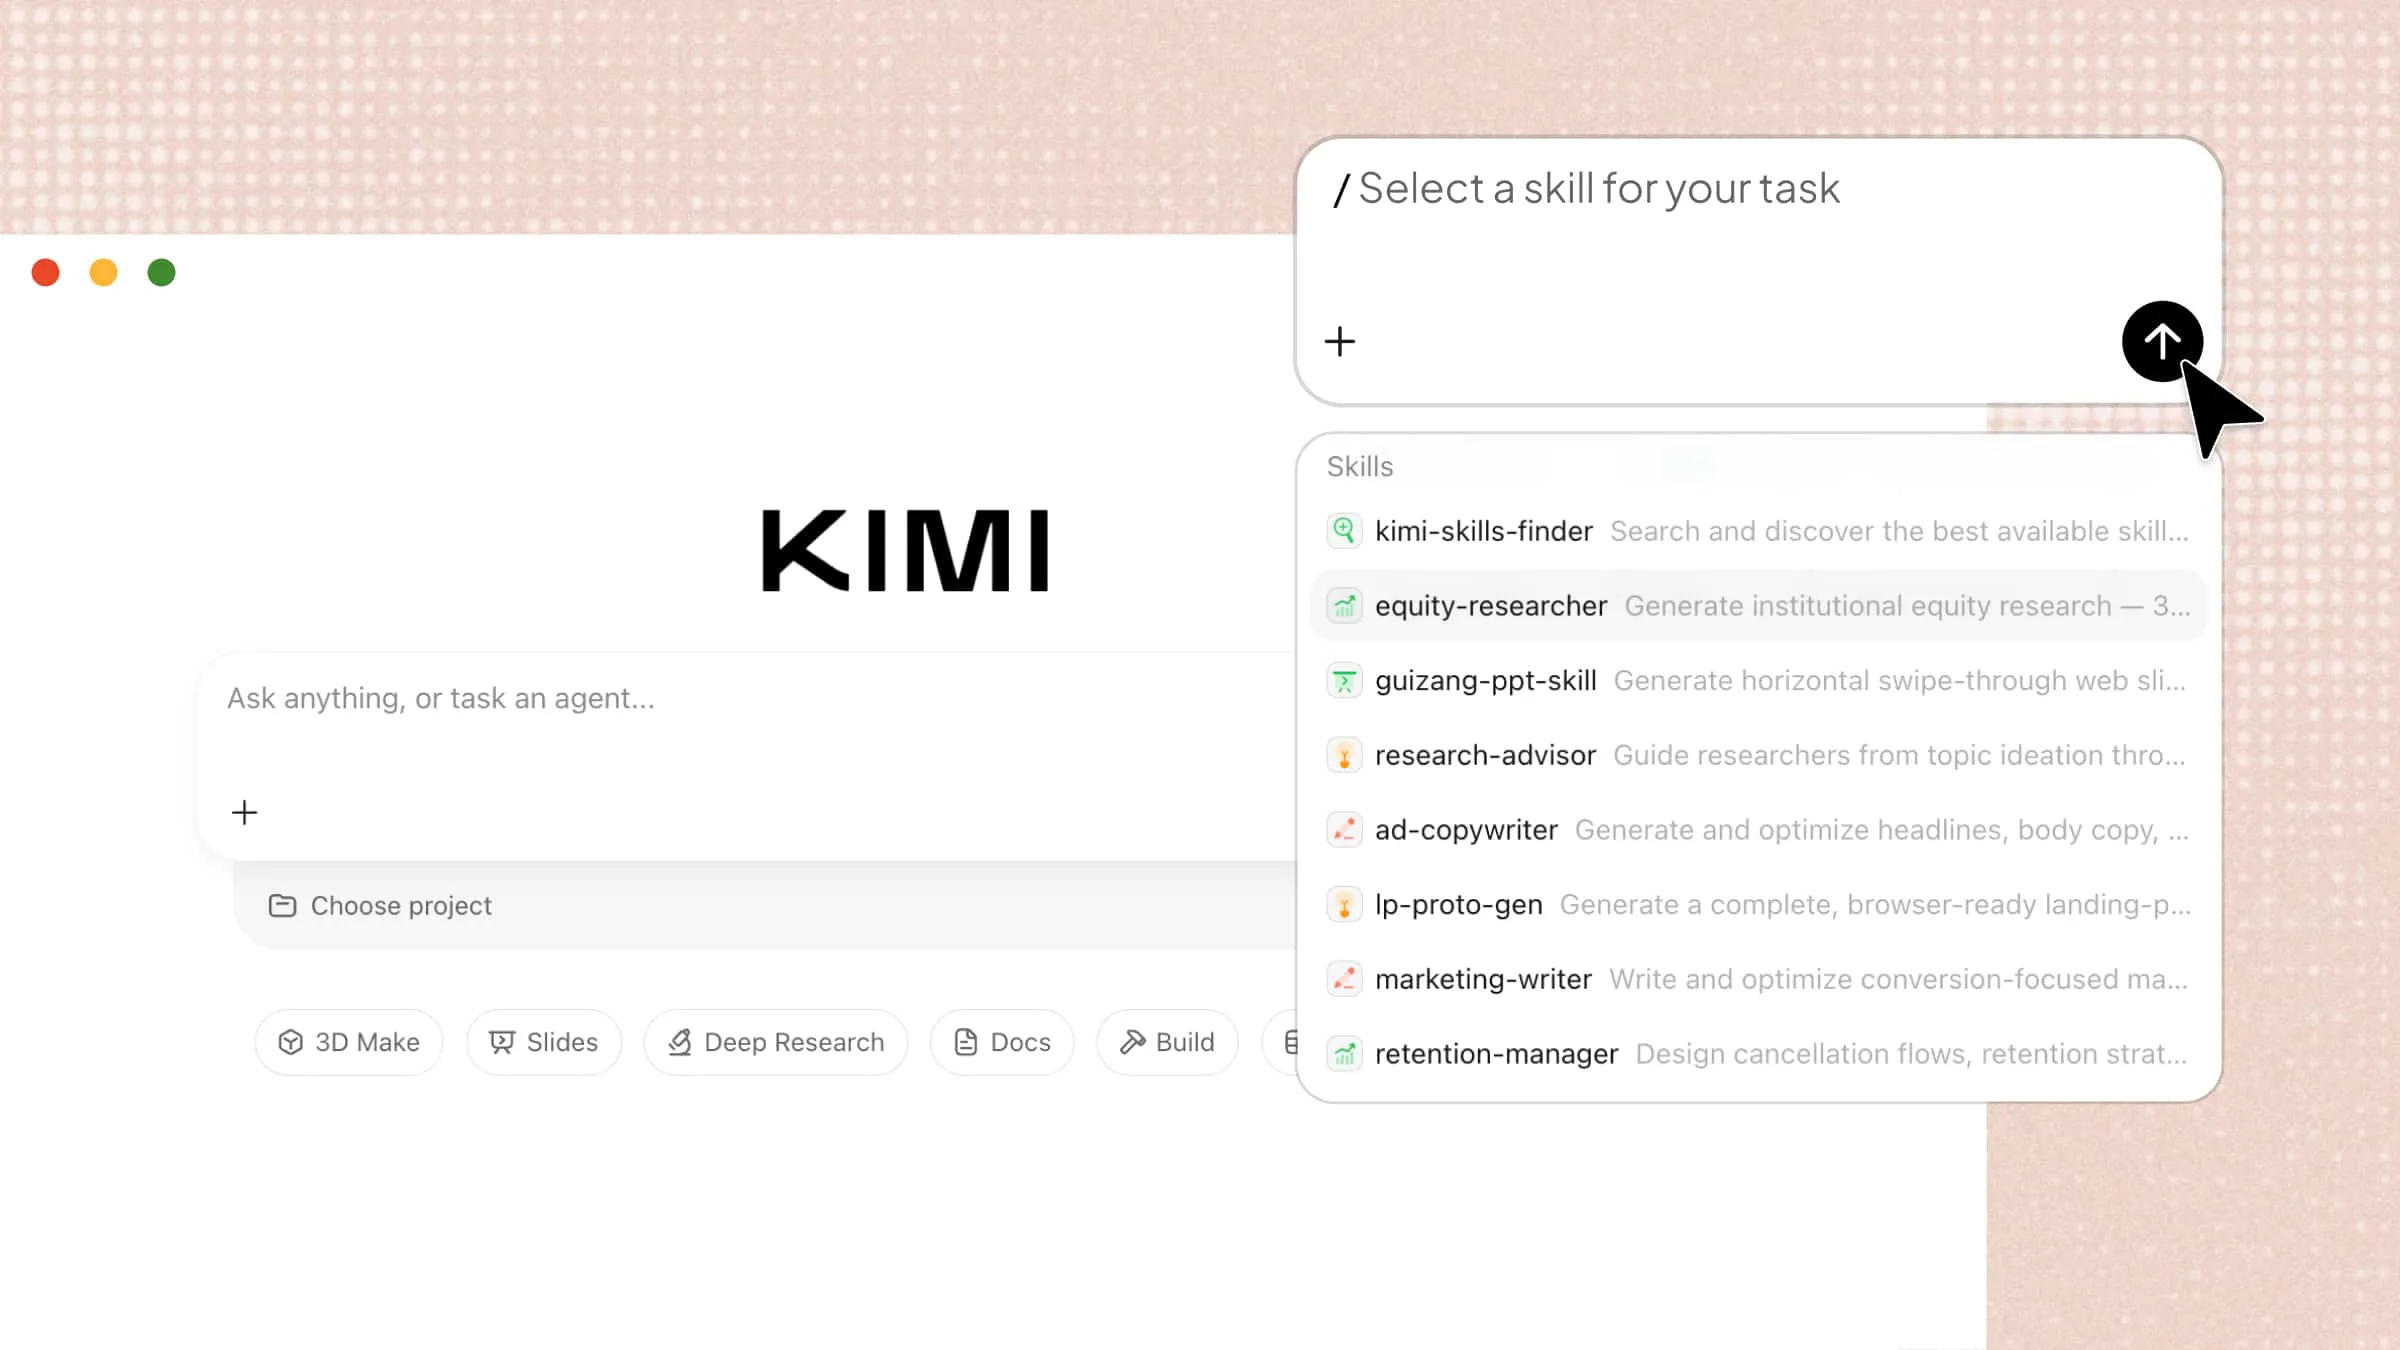
Le portefeuille de harnais de Moonshot AI transpose sur une pile gérée l’anatomie définie plus haut dans cet article. Pour le problème Agent × Computer, ses harnais étendent la boucle standard : Kimi Browser Extension pilote une véritable session de navigateur via le Chrome DevTools Protocol plutôt qu’un bac à sable stérile, une interface Demander avant d’agir impose le consentement au niveau du système de fichiers, et un Agent Swarm étend l’orchestration à 300 sous-agents pour les tâches de longue durée.
Cette boucle est pilotée par Kimi K3.1 Pro — le premier modèle de la série K3.1 et, à ce jour, le modèle open-weight de classe 3T le plus capable de Moonshot AI, avec une fenêtre de contexte de 1 048 576 token. Trois de ses propriétés ont une incidence directe sur la conception du harnais :
Une fenêtre suffisamment grande pour repousser la compaction. Un million de token peut contenir simultanément un dépôt de travail, la trajectoire en cours et les documents de référence. Le harnais tronque toujours — il le doit — mais le seuil à partir duquel la synthèse commence à détruire de l’information est suffisamment repoussé pour que les tâches de longue durée cessent de se dégrader discrètement à mi-parcours.
L’effort de raisonnement comme réglage du harnais. K3.1 Pro raisonne toujours, et
reasoning_effortacceptelow,highoumax,maxétant la valeur par défaut. Le coût de raisonnement du modèle devient ainsi un budget défini par le harnais pour chaque tâche, plutôt qu’un coût d’entrée fixe.Des outils qui arrivent en cours d’épisode. Le chargement dynamique d’outils permet au harnais d’injecter une définition complète d’outil dans un message système, de sorte qu’un outil devient disponible à partir de ce message — sans redémarrage et sans payer son schéma à chaque tour d’une conversation qui ne l’utilise jamais.
Moonshot publie les résultats du harnais en même temps que ceux du modèle, ce que préconise le reste de cet article. Sur Terminal-Bench 4.0 — qui évalue les agents de codage sur des tâches de terminal réalistes, aux ressources contraintes, au moyen de tests stricts propres à chaque tâche — K3.1 Pro atteint 65,7 %, devant GPT-6 Astra (58,2 %) et juste derrière Claude Opus 5.5 (66,4 %). Sur Kimi Code Bench 3.0 Long-horizon, un benchmark interne portant sur l’exécution en plusieurs étapes, l’utilisation d’outils et la résolution de problèmes de bout en bout, il obtient 61,2 % contre 55,95 % pour K3. La documentation est tout aussi explicite sur le couplage dans l’autre sens : les paramètres d’échantillonnage tels que temperature et top_p sont fixes et doivent être omis des requêtes, et le message complet de l’assistant doit être renvoyé sans modification d’un tour à l’autre ; un harnais qui réécrit le message perd le raisonnement dont dépend l’appel d’outil suivant.
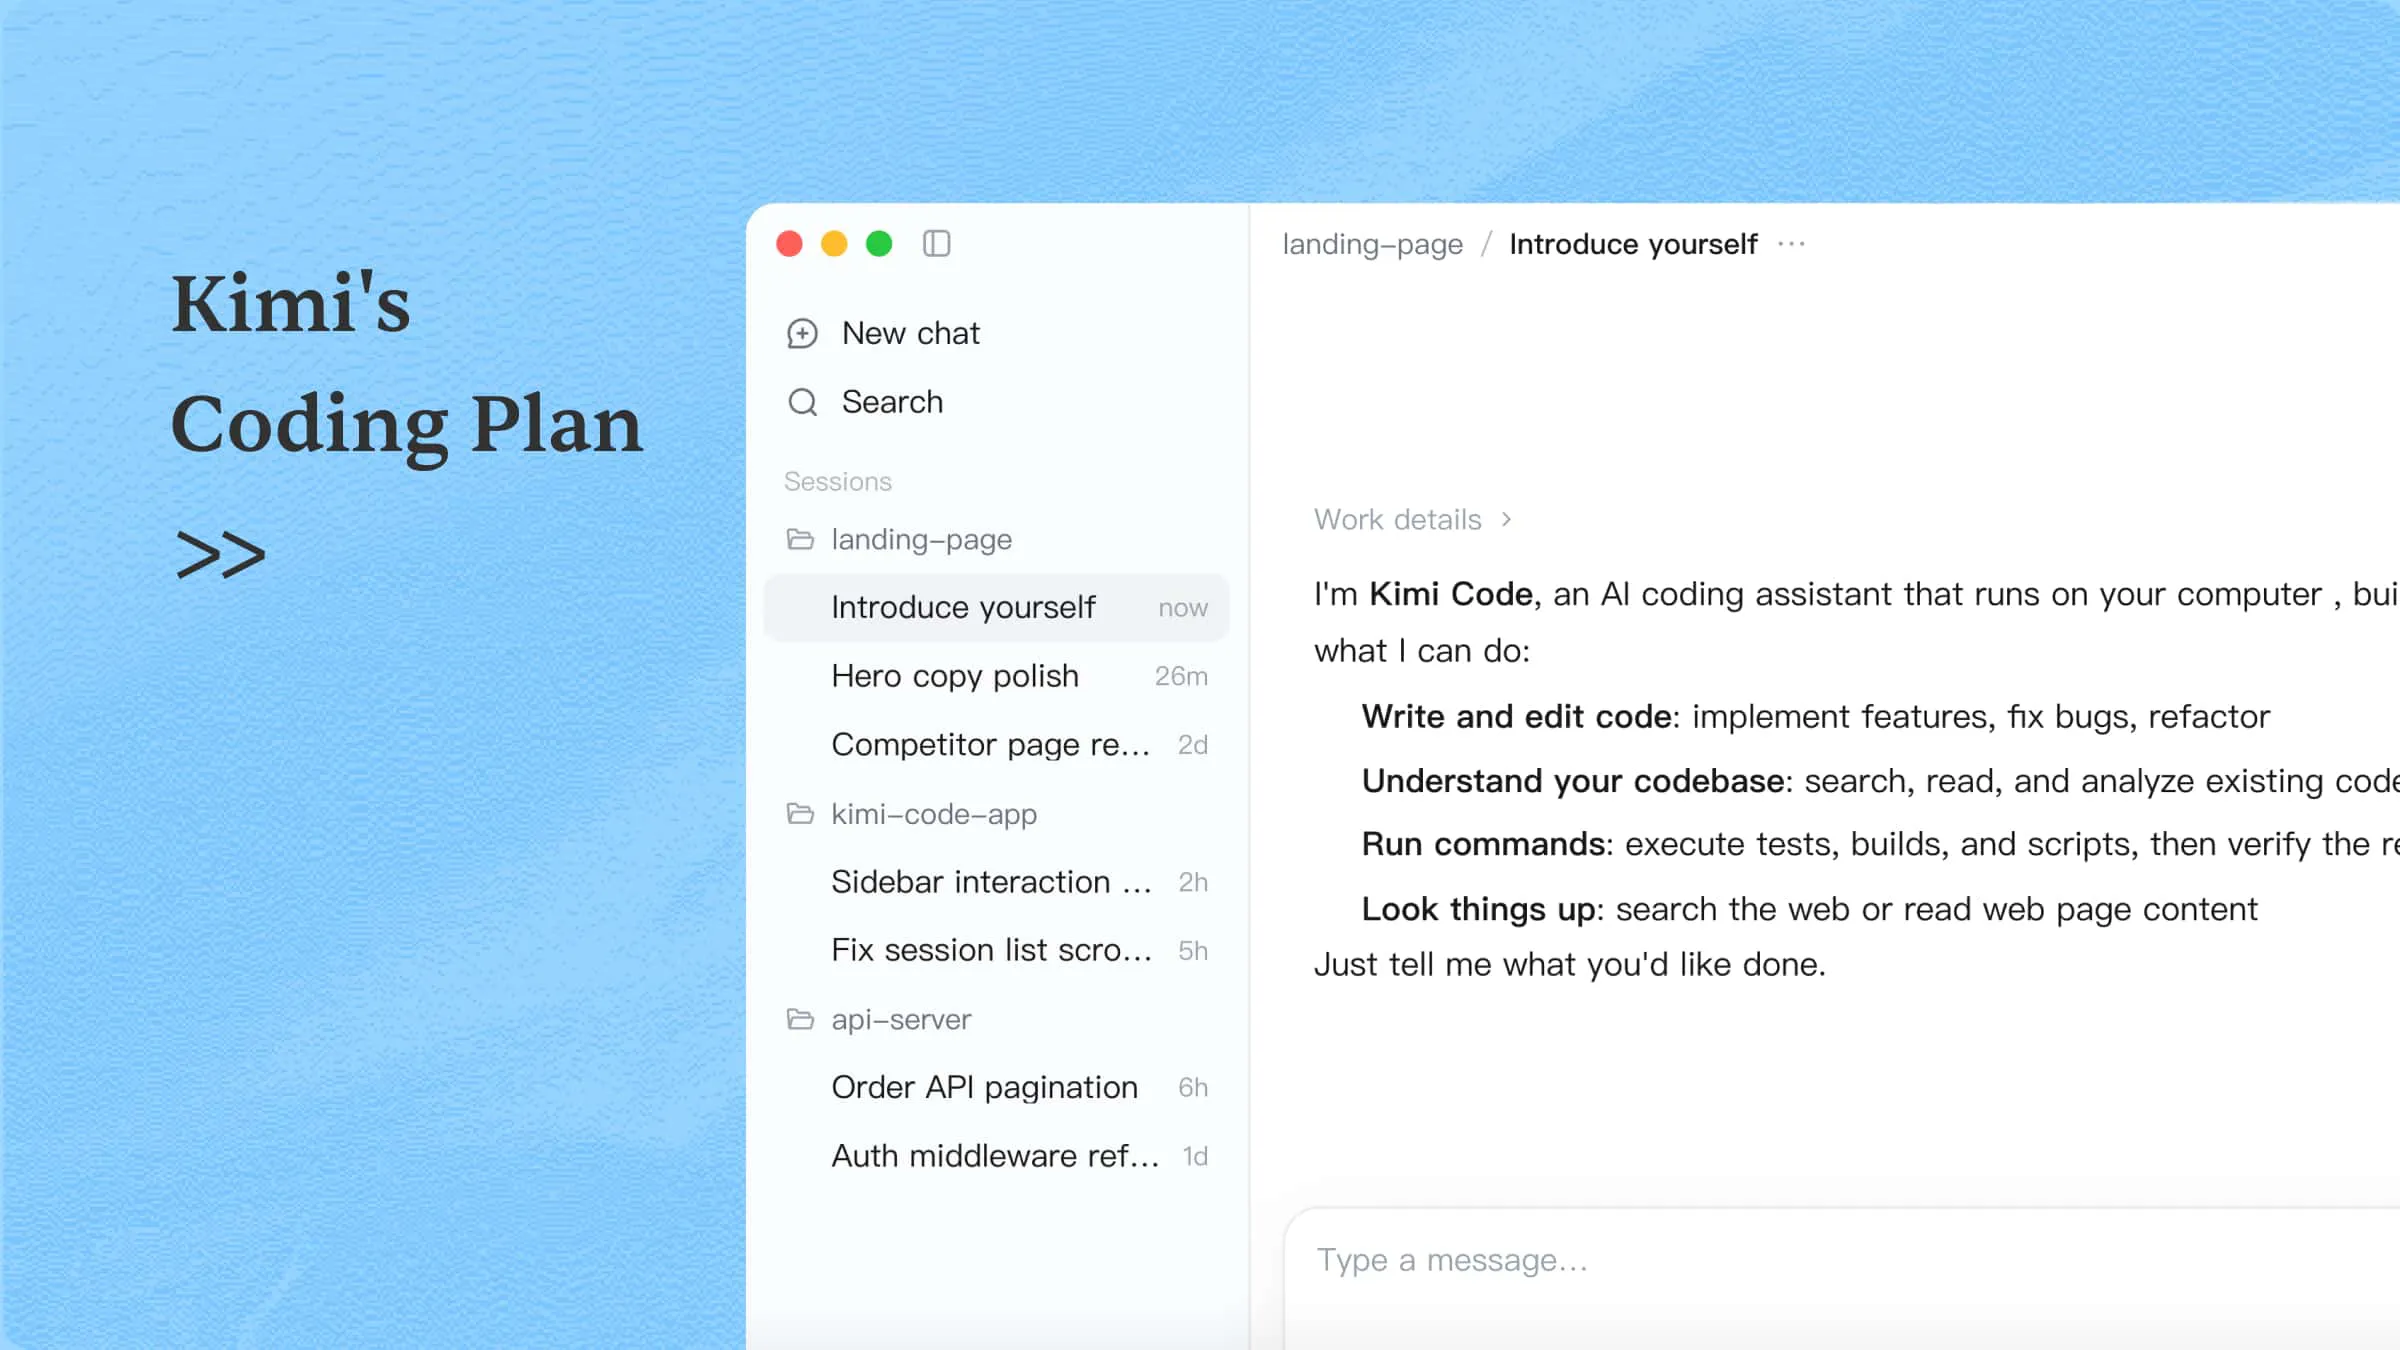
Le même modèle alimente toute la gamme. Vous pouvez essayer la version web gérée via Kimi Agent, exécuter le harnais local complet avec Kimi Work, travailler dans le terminal avec Kimi Code, ou appeler directement kimi-k3.1-pro via la Kimi API. Une variante kimi-k3.1-pro-highspeed échange environ le double du prix par token contre une vitesse de sortie deux à trois fois supérieure.
Comment choisir ou créer votre propre harnais d’agent
Que vous évaluiez des modèles ou lanciez un produit, la même liste de contrôle s’applique :
Partez de la tâche, pas du framework. Si vos agents modifient du code, un harnais Bash plus éditeur comme l’ACI de SWE-agent a fait ses preuves. S’ils pilotent des interfaces graphiques ou le web en direct, vous avez besoin d’observations de sessions réelles et d’actions au niveau du clic.
Rendez les environnements reproductibles. Les images Docker, les dépendances épinglées et les données initialisées par graine font la différence entre un benchmark et une anecdote.
Allouez délibérément la fenêtre de contexte. La troncature des observations, la synthèse de l’historique et la compaction sont des fonctionnalités du harnais qui influent directement sur les scores et les coûts — et expliquent pourquoi les modèles à long contexte réduisent ce que le harnais doit supprimer.
Imposez des limites strictes. Des plafonds d’étapes, des délais d’expiration réels et des budgets en dollars par épisode garantissent la sécurité des agents et la comparabilité des évaluations.
Consignez les trajectoires complètes dès le premier jour. Toute boucle d’amélioration sérieuse — revue humaine, regroupement des échecs, fine-tuning — consomme des données de trajectoire. Managed Agents d’Anthropic et DeepSeek Harness vont plus loin : ils conservent le journal de session hors de la boucle du harnais sous la forme d’un flux d’événements en ajout seul, de sorte que le harnais est lui-même remplaçable et que le contexte du modèle reste toujours reconstructible.
Évaluez sur plusieurs harnais. Si votre agent ne fonctionne qu’au sein d’un seul harnais, vous avez créé un comportement spécifique à ce harnais, pas une capacité.
Gardez les identifiants hors du bac à sable — voire entièrement hors du cloud. Considérez l’environnement d’exécution de l’agent comme non fiable ; conservez les token dans un coffre-fort et injectez-les via un proxy, ou exécutez toute la session localement afin que les identifiants et le contenu des pages ne quittent jamais l’appareil — l’approche retenue par Kimi pour ses harnais locaux.
Conclusion
Le harnais d’agent est discrètement devenu la couche la plus importante de la pile agentique. Les recherches de SWE-bench, mini-SWE-agent, Terminal-Bench et METR montrent que la conception du harnais peut avoir autant d’impact que les améliorations de modèle ; des projets open source comme DeepSeek Harness, OpenHands, SWE-agent et Aider mettent des harnais de niveau production à la portée de tous ; et Anthropic, OpenAI, Google, Microsoft et Moonshot AI considèrent désormais tous l’ingénierie des harnais comme un travail de premier plan.
Mais le changement le plus profond est conceptuel. La première génération de harnais a résolu le problème Agent × Computer : donner à un modèle des mains fiables pour un terminal, un navigateur, un système de fichiers. La génération suivante résout le problème de contexte créé par ces environnements — un travail qui s’étend sur des jours, des parties prenantes et des dépôts qu’aucun synthétiseur ne compresse sans perte. Le harnais évolue d’un échafaudage vers un environnement d’exploitation, et la frontière entre ce que le harnais doit gérer et ce que le modèle peut simplement retenir ne cesse de se déplacer. La fenêtre d’un million de token de Kimi K3.1 Pro en est l’exemple actuel le plus clair : une modification du modèle qui supprime un travail que le harnais devait auparavant effectuer.
Que vous construisiez le vôtre, adoptiez un framework open source ou exploitiez un harnais en production, les équipes qui considèrent le harnais comme un logiciel conçu, versionné et mesurable sont celles dont les agents terminent réellement le travail.
FAQ
kimi-k3.1-pro. Pour la conception d'un harnais, les deux propriétés les plus importantes sont la fenêtre de contexte, qui repousse le moment où la compaction des trajectoires commence à faire perdre des informations, et reasoning_effort, qui permet au harnais de définir un budget de raisonnement par tâche. Une variante kimi-k3.1-pro-highspeed échange un prix par token plus élevé contre une vitesse de sortie deux à trois fois supérieure.