
L’utilisation gratuite des API de LLM permet aux développeurs de tester des modèles et de prototyper des fonctionnalités d’IA avant de s’engager dans des coûts récurrents. Toutefois, l’accès gratuit se présente sous différentes formes, allant d’allocations d’utilisation renouvelables à des crédits d’essai limités, chacune avec ses propres restrictions. Choisir un fournisseur implique de mettre ces conditions en regard des capacités des modèles et du coût de la montée en charge au-delà de l’utilisation gratuite. Ce guide compare 10 API de LLM gratuites et payantes, en expliquant ce que chacune propose, comment l’accès est tarifé et à quels projets elle convient.
Présentation de 10 API de LLM gratuites et payantes
La comparaison ci-dessous couvre les fournisseurs de modèles, les plateformes multi-fournisseurs et les outils de déploiement NVIDIA. Les formats d’entrée résument les capacités des plateformes et varient selon le modèle et le point de terminaison ; la parole, les représentations vectorielles et la génération d’images ou de vidéos peuvent utiliser des API distinctes. Les conditions d’accès ont été vérifiées le 13 novembre 2026. Une allocation gratuite renouvelable, une clé d’évaluation, une promotion de rechargement et un logiciel téléchargeable gratuitement offrent différents types d’accès.
| API LLM | Entrées prises en charge | Fonctionnalités clés | Accès gratuit | Principales limites | Accès payant | Adapté à |
|---|---|---|---|---|---|---|
| Kimi API | Texte, images, vidéo, selon le modèle | Raisonnement, programmation, compréhension visuelle, traitement de longs contextes | Pas d'offre gratuite permanente ; promotion de bons de recharge | Recharge minimale de 1 $ ; bon de 5 $ après 5 $ de recharges cumulées ; limites de débit du compte applicables | Tarification de l'API à l'usage | Analyse de documents longs, agents d'IA, assistants de programmation |
| Google Gemini API | Texte, images, audio, vidéo | Raisonnement, programmation, appel de fonctions, embeddings | Offre gratuite pour certains modèles | Limites de RPM, TPM et quotidiennes propres au modèle ou au projet | Utilisation à la carte | Applications multimodales, assistants d'IA, outils de recherche |
| GroqCloud | Texte, images, audio, selon le modèle | Inférence rapide, raisonnement, programmation, traitement de la parole | Offre gratuite pour développeurs | Limites de RPM, RPD, TPM et TPD propres au modèle | Limites plus élevées avec les offres payantes | Chatbots en temps réel, applications vocales |
| OpenRouter | Texte, images, selon le modèle | Routage de modèles, raisonnement, programmation, changement de fournisseur | Certaines variantes de modèles gratuites | 20 requêtes/minute ; 50/jour, puis jusqu’à 1 000/jour après 10 $ d’achats cumulés de crédits ; les tentatives échouées sont comptabilisées | Paiement à l’usage pour les modèles payants | Applications multi-modèles, tests de modèles |
| Cloudflare Workers AI | Texte, images, audio, selon le modèle | Inférence LLM, embeddings, génération d’images, traitement de la parole | 10 000 Neurons gratuits par jour pour les modèles éligibles | Les Neurons mesurent la consommation de calcul, et non le nombre de requêtes ou de tokens | Workers Paid requis au-delà de l’allocation ; 0,011 $ pour 1 000 Neurons en cas d’utilisation excédentaire de l’IA | Applications d’IA serverless, chatbots basés sur l’edge |
| Mistral AI API | Texte, images, selon le modèle | Raisonnement, programmation, embeddings, sorties structurées | Le mode gratuit de Vibe/Studio n’inclut pas l’accès à l’API | Activation de la facturation et paiement à l’usage requis ; des limites s’appliquent selon le modèle et l’organisation | Activation de la facturation et utilisation à l’usage | Agents d’IA, systèmes RAG, applications métiers |
| Catalogue API NVIDIA et NIM | Texte et autres entrées dépendant du modèle | API de modèles hébergés, inférence LLM auto-hébergée, déploiement de modèles optimisé | Points de terminaison hébergés pour le prototypage ; les logiciels NIM et NIM Certified Feature Branch sont disponibles gratuitement selon les conditions applicables | Les limites de débit des services hébergés varient ; l’utilisation auto-hébergée dépend des licences des modèles et du matériel GPU pris en charge | Coûts GPU/cloud distincts ; abonnement AI Enterprise requis pour Certified Production Branch et le support entreprise | Déploiement d’IA privé, applications d’entreprise, inférence accélérée par GPU |
| Cohere API | Texte et images sur les modèles pris en charge ; audio via une API distincte | Génération de texte, embeddings, reranking, recherche | Clé d’évaluation gratuite | 1 000 appels d’essai/mois ; les limites des points de terminaison et l’approbation pour la production varient selon le modèle | Accès à la production payant ; certains modèles plus récents nécessitent l’approbation des équipes commerciales | Recherche d’entreprise, RAG, gestion des connaissances |
| Together AI API | Texte, images, selon le modèle | Inférence LLM, fine-tuning, embeddings, génération d’images et de vidéos via des API distinctes | Aucun essai gratuit standard de l’API | Achat initial de crédits requis | Utilisation prépayée ; premier achat minimum de 15 $, recharges ultérieures de 5 $ | Modèles d'IA personnalisés, expérimentation de modèles |
| Novita AI | Texte et autres entrées selon le modèle | Inférence LLM, génération d'images et génération de vidéos via des API distinctes | La précédente campagne de parrainage est terminée ; aucune allocation gratuite continue n'est supposée | Les promotions en cours, le cas échéant, doivent être confirmées dans la console ; l'offre de parrainage terminée ne constitue pas une offre gratuite | Tarification selon le modèle | Applications créatives d'IA, plateformes multimodales |
Remarque : Cette comparaison est fournie à titre indicatif uniquement. Les tarifs, les allocations gratuites, la disponibilité des modèles, les fonctionnalités et les limites d’utilisation peuvent évoluer et varier selon la région, le compte et le modèle sélectionné. Pour connaître les informations les plus récentes et les conditions applicables, consultez le site web officiel et la documentation de chaque fournisseur avant de vous inscrire ou d’utiliser ses services.
10 API de LLM gratuites et payantes à essayer
Face au grand nombre de fournisseurs d’API de LLM disponibles, choisir le bon peut prendre du temps. Pour faciliter votre recherche, voici 10 API de LLM gratuites et payantes, avec leurs principales fonctionnalités, leurs options tarifaires, les capacités de leurs modèles et ce qu’elles proposent pour différents projets d’IA et besoins de développement :
Kimi API
Kimi API donne aux développeurs accès à des modèles d’IA pour le raisonnement avancé, le codage et le traitement de longs contextes. Elle prend en charge l’intégration d’API compatibles avec OpenAI, ce qui facilite la connexion des modèles Kimi aux applications existantes et aux workflows de développement. Actuellement, lorsque le montant cumulé des rechargements atteint 5 $, les utilisateurs reçoivent un bon de 5 $.
Coût de l’API : Le tarif international de kimi-k3.1-pro est de 2 $ par million de tokens d’entrée non mis en cache et de 10 $ par million de tokens de sortie, hors taxes applicables. Les accès au cache coûtent 0,20 $ par million de tokens ; les écritures dans le cache coûtent 2 $ pour une TTL de 5 minutes ou 4 $ pour une TTL d’une heure. Ces catégories d’entrée s’excluent mutuellement. L’utilisation de l’API est facturée séparément des abonnements aux produits Kimi. Consultez les tarifs de l’API et la facturation du cache.
Fonctionnalités principales
Raisonnement avancé pour les tâches complexes : Traite les questions en plusieurs étapes, analyse des informations complexes et relie les détails pertinents afin de générer des réponses bien structurées. Il convient ainsi à la recherche, à la résolution de problèmes et aux applications qui exigent davantage que la simple génération de texte.
Assistance au codage par IA : Aide les développeurs à générer du code, à identifier des erreurs, à déboguer des problèmes, à expliquer du code peu familier et à améliorer des implémentations existantes dans différents langages de programmation. Elle peut servir de base à des assistants de codage et à des workflows de développement propulsés par l’IA.
Compréhension des longs contextes : Traite des documents volumineux, des textes étendus et de grandes bases de code tout en conservant le contexte pertinent. Les développeurs peuvent créer des applications d’analyse de documents, d’extraction d’informations, de synthèse et de questions-réponses tenant compte du contexte.
Compréhension multimodale : Les modèles Kimi pris en charge peuvent traiter des entrées visuelles en parallèle du texte, ce qui permet aux applications d’interpréter des images, des captures d’écran, des graphiques et d’autres informations visuelles. Cela élargit les cas d’utilisation possibles au-delà des applications d’IA uniquement textuelles.
Intégration d’API compatible avec OpenAI : Prend en charge le format d’API OpenAI, ce qui permet aux développeurs d’utiliser des SDK compatibles et des workflows d’intégration familiers. Cela simplifie la connexion des modèles Kimi aux applications existantes et l’expérimentation de différentes fonctionnalités propulsées par l’IA.
Idéal pour
Créer des applications et des chatbots propulsés par l’IA
Développer des assistants de codage et des outils d’automatisation
Analyser de grands documents et jeux de données
Créer des agents d’IA nécessitant des capacités de raisonnement et de résolution de problèmes
Premiers pas avec Kimi API
Suivez ces quatre étapes pour créer un compte Kimi API, l’approvisionner, configurer l’accès et vérifier une première requête. L’exemple utilise la plateforme API internationale et une question type sur la politique de retour.
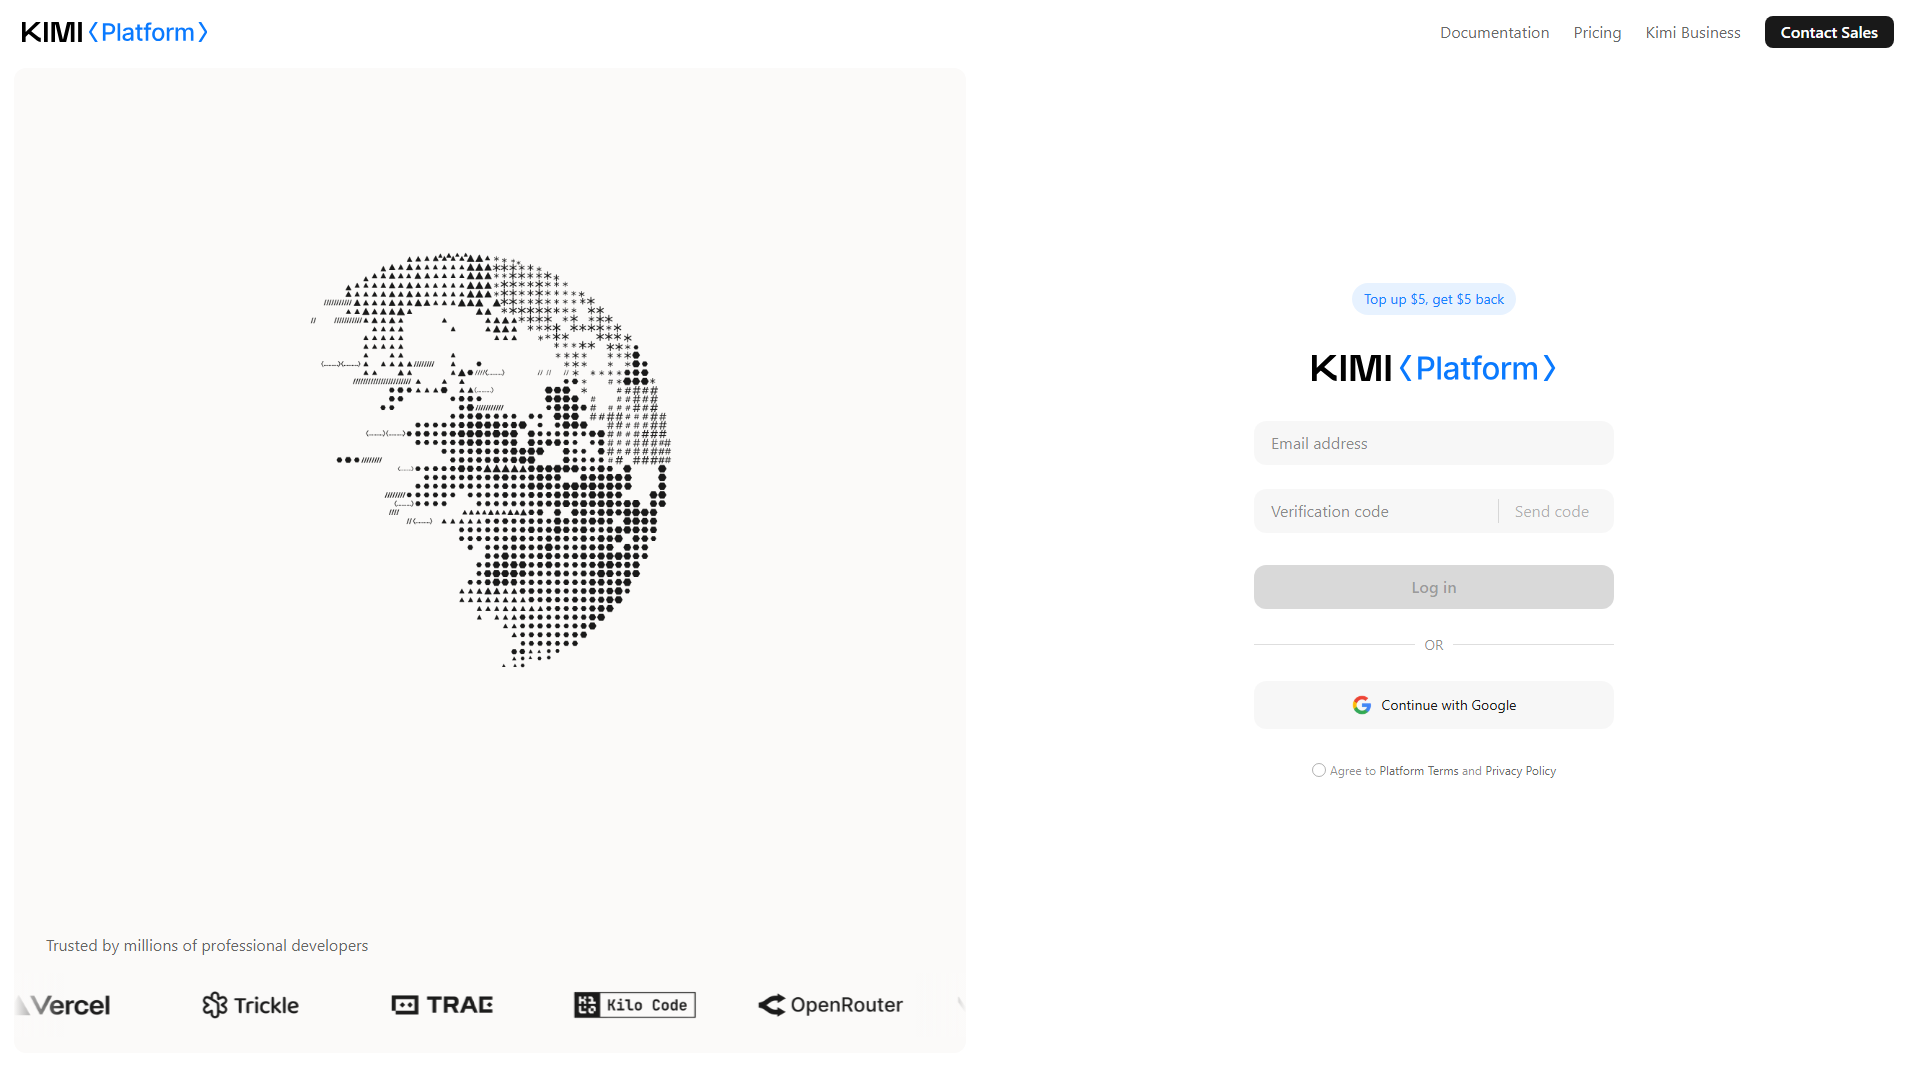
Étape 1. Créer un compte développeur
Accédez à la plateforme Kimi API et créez un compte développeur. Connectez-vous pour accéder à la console API, où vous pouvez gérer vos clés API, votre utilisation et votre facturation.
Étape 2. Générer une clé API
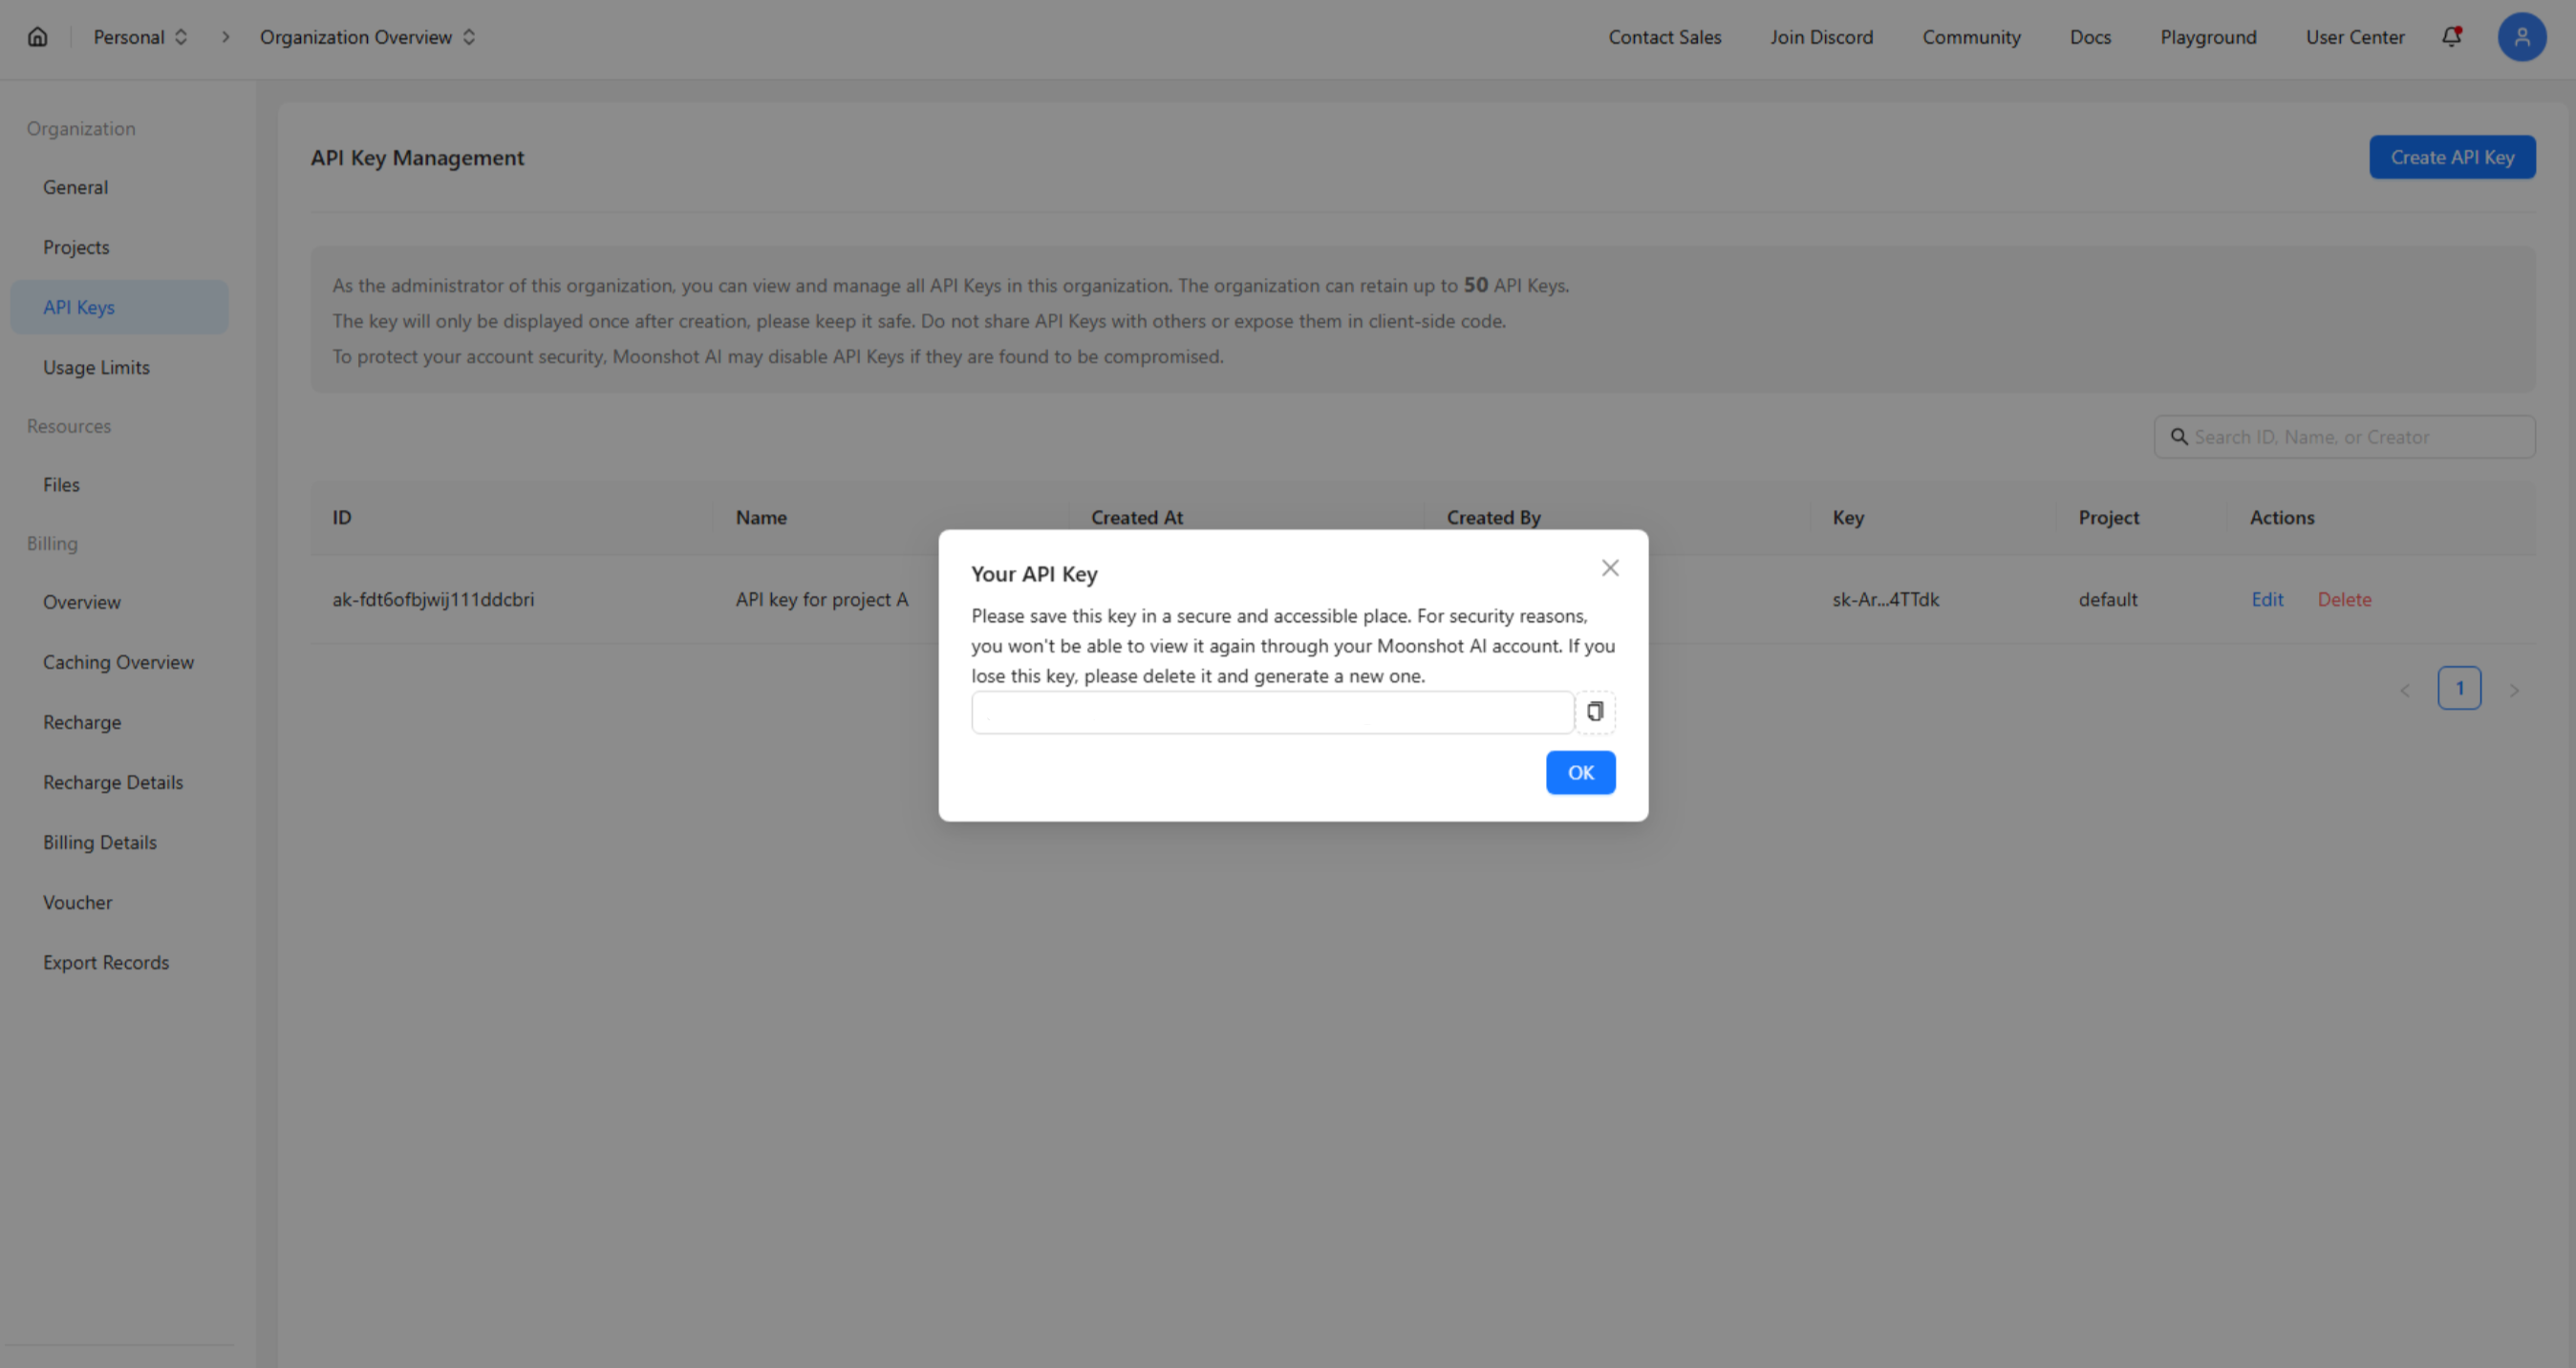
Ouvrez la section de gestion des clés API dans la console et cliquez sur Create API Key. Saisissez un nom pour identifier votre clé, confirmez sa création et copiez la clé générée.
Protégez votre clé API. Stockez-la dans une variable d'environnement côté serveur ou dans un gestionnaire de secrets, et ne l'exposez jamais dans des dépôts publics ou du code côté client.
Étape 3. Activez et configurez votre accès à l'API
Avant d'effectuer votre premier appel API, ajoutez des crédits à votre compte. La recharge initiale minimale est de 1 $. Vérifiez ensuite le solde de votre compte, l'accès aux modèles disponibles et les limites de débit applicables dans la console.
Cet exemple utilise l'URL de base internationale https://api.moonshot.ai/v1 et le modèle kimi-k3.1-pro. Utilisez une clé API issue du compte de la plateforme correspondante. Définissez la clé dans un terminal compatible Bash sur macOS ou Linux ; sous Windows, utilisez un environnement Bash tel que WSL pour ces commandes :
Exécutez la requête suivante dans le même terminal afin qu'elle puisse lire la variable d'environnement. N'insérez jamais de clé API active dans des exemples publics ou du code frontend.
Étape 4. Envoyez votre première requête API
Une fois votre compte approvisionné et votre configuration API prête, envoyez une requête de test pour vérifier la connexion. Vous pouvez par exemple utiliser un scénario de service client afin de tester la manière dont Kimi traite une question simple sur une politique de retour.
Cet exemple Bash/cURL envoie l'exemple de politique de retour et les informations du client à Chat Completions. Il utilise reasoning_effort: "low" pour ce test simple :
L'API renvoie une réponse JSON contenant la réponse du modèle dans choices[0].message.content. Une réponse réussie confirme que votre clé API, votre endpoint et la configuration de votre modèle fonctionnent pour cette requête de base. Vous pouvez ensuite adapter l'exemple en remplaçant le prompt de test par les instructions de votre application et les données client.
API Google Gemini
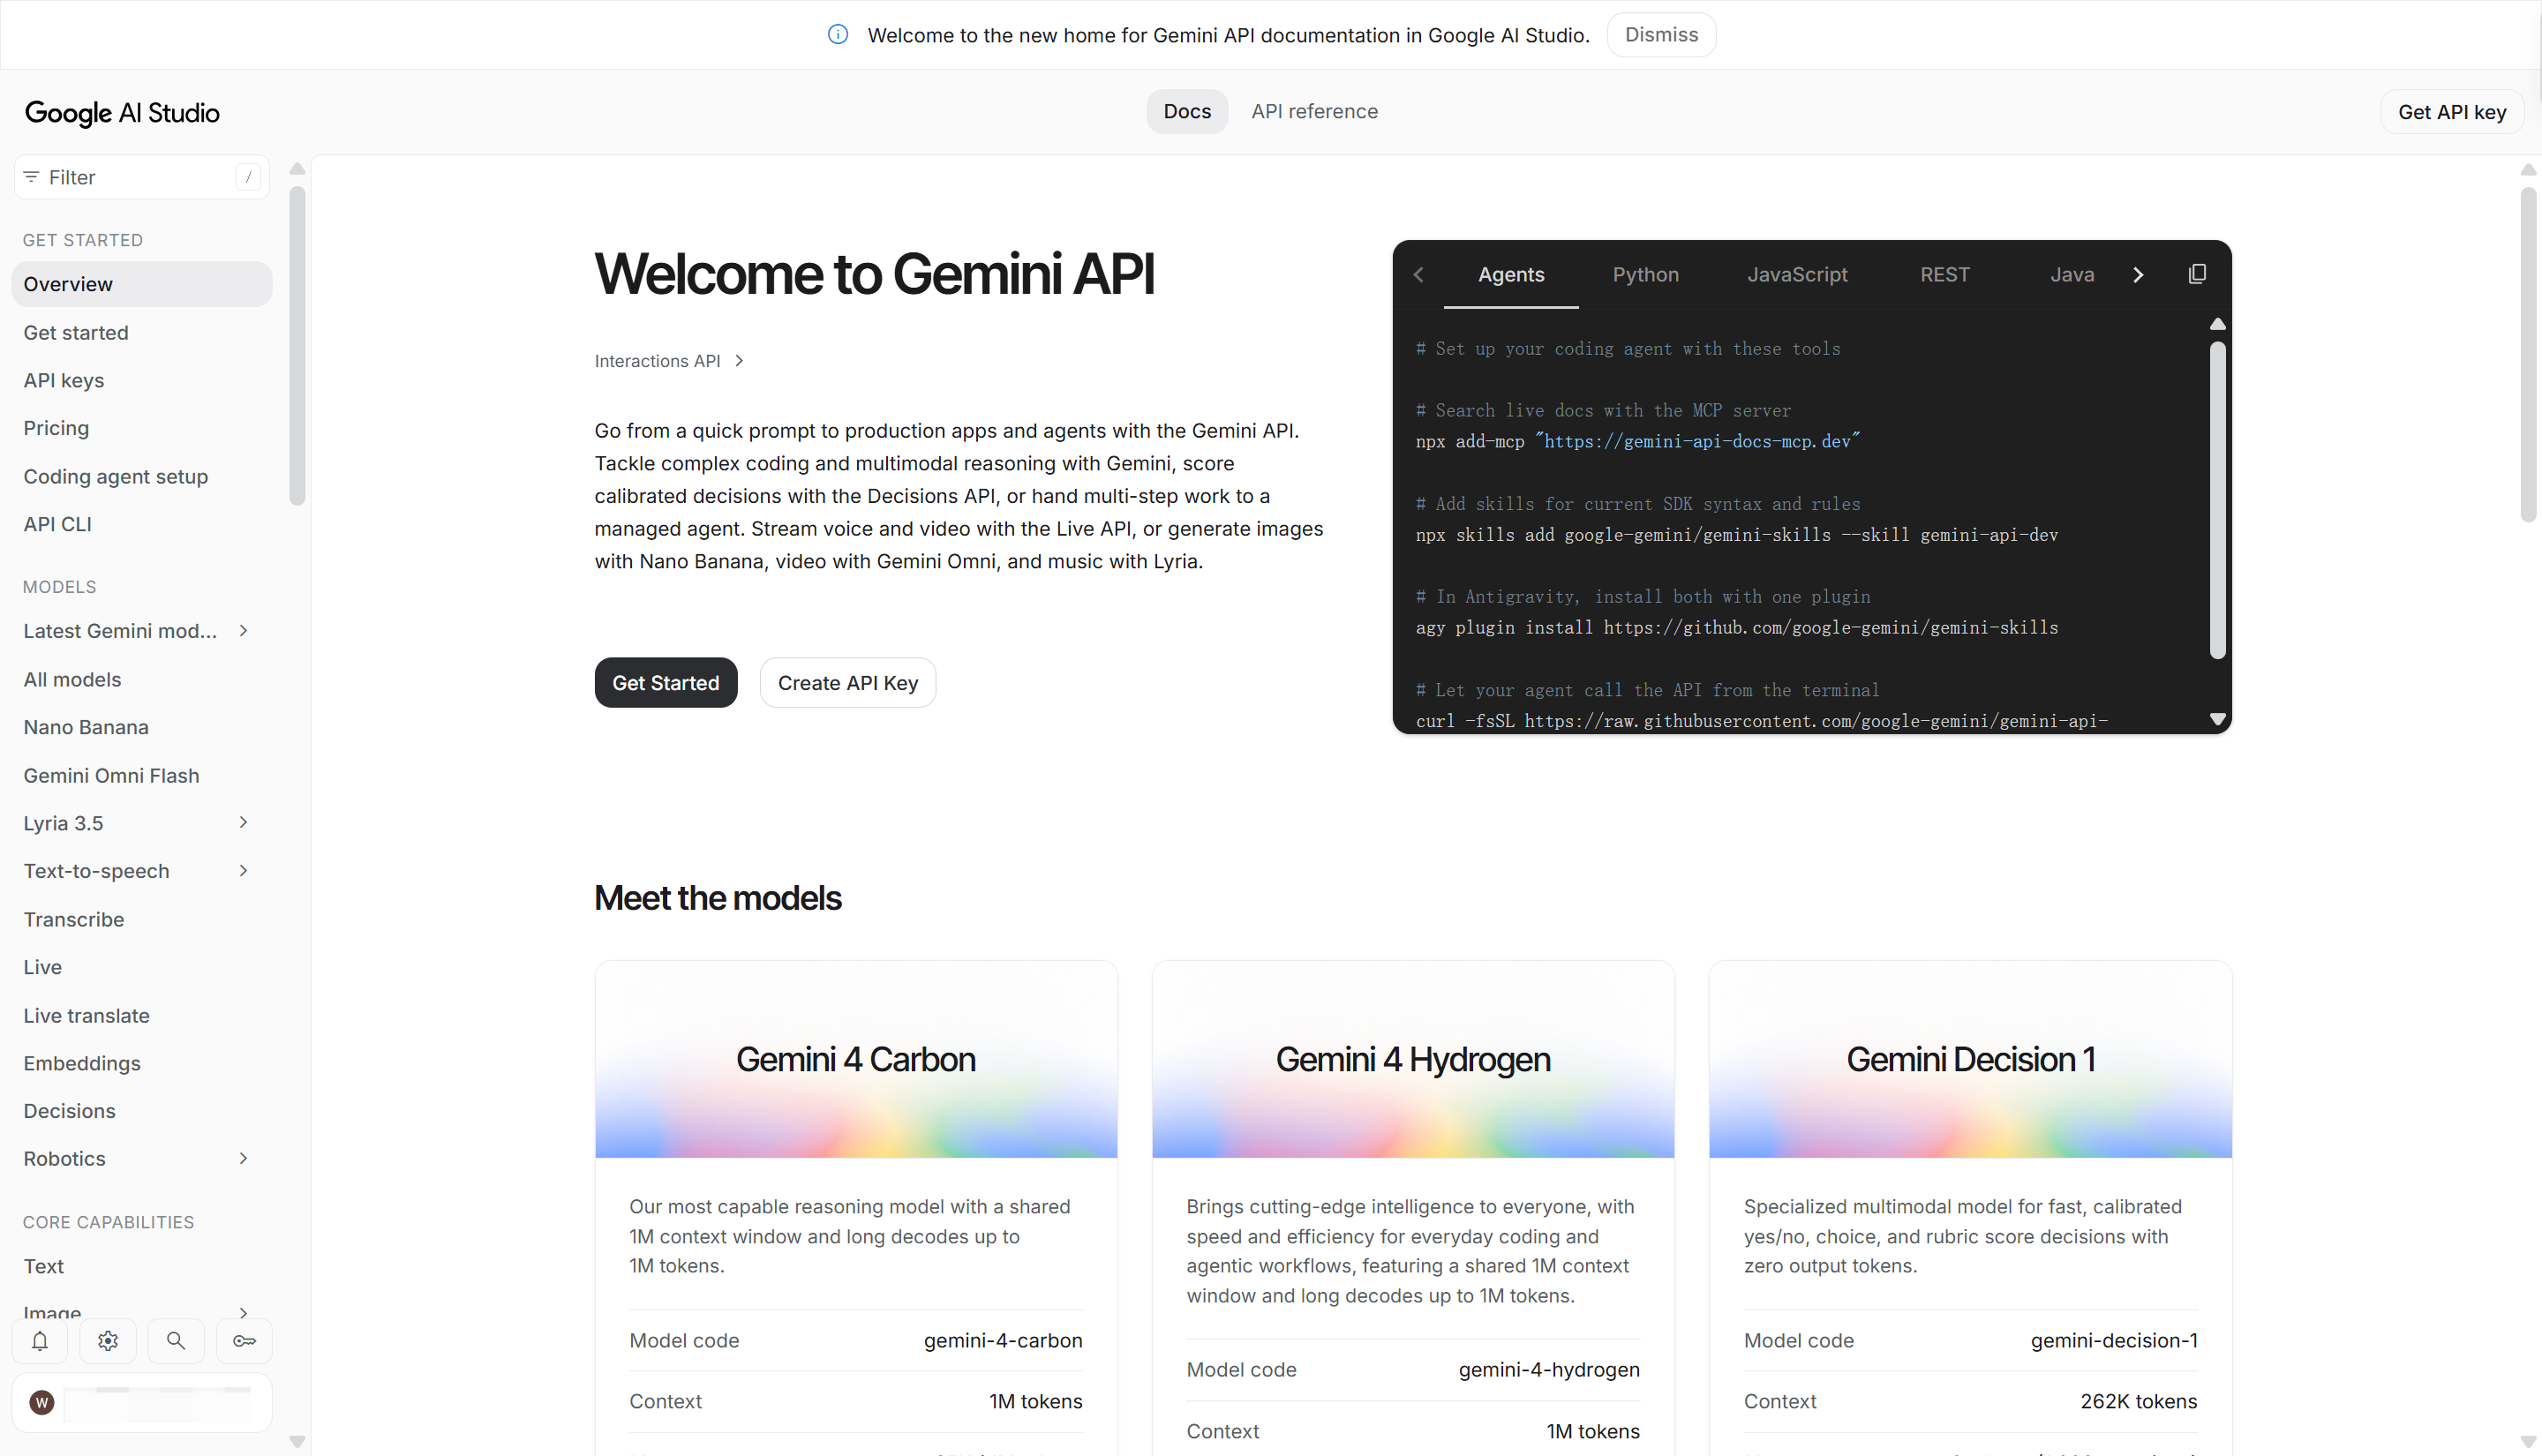
L'API Google Gemini permet aux développeurs de connecter les modèles d'IA de Google à leurs applications. Elle prend en charge le texte, les images, l'audio et la vidéo, ce qui la rend utile pour créer des applications qui traitent différents types de contenus. Les développeurs peuvent l'utiliser pour la génération de contenu, l'analyse de données, le codage, etc. Elle donne également accès à différents modèles Gemini selon les besoins du projet. L'offre gratuite de Gemini couvre certains modèles, avec des quotas indiqués dans AI Studio.
Principales fonctionnalités
Fonctionnalités multimodales : prend en charge les entrées textuelles, image, audio et vidéo via des modèles Gemini compatibles, ce qui permet aux applications de traiter différents types de contenus.
Longue fenêtre de contexte : traite de grands documents et de longues conversations dans une seule requête.
Appel de fonctions : connecte les modèles d'IA à des outils externes, des API et des fonctions d'application.
Sorties structurées : génère des réponses dans des formats tels que JSON pour faciliter l'intégration aux applications.
Idéal pour
Créer des applications d'IA multimodales
Créer des chatbots et assistants virtuels basés sur l'IA
Analyser des documents, des images et des vidéos
Développer des outils de recherche et de productivité basés sur l'IA
GroqCloud
GroqCloud fournit un accès API à des modèles de langage exécutés sur les unités de traitement du langage (LPU) spécialisées de Groq. Son infrastructure d'inférence est conçue pour un traitement à haute vitesse et des réponses à faible latence. Les développeurs peuvent accéder à plusieurs modèles pris en charge via une API unifiée, avec des endpoints compatibles OpenAI qui simplifient l'intégration dans les applications existantes.
Limites de l'offre gratuite : l'offre gratuite de Groq est soumise à des limites d'utilisation des requêtes et des token propres à chaque modèle.
Principales fonctionnalités
Inférence rapide : utilise l'infrastructure de Groq basée sur les LPU pour offrir une inférence rapide et des réponses à faible latence.
API compatible OpenAI : prend en charge des interfaces API familières, ce qui facilite la migration des applications existantes.
Choix des modèles : donne accès à plusieurs modèles à poids ouverts pris en charge.
Réponses en streaming : diffuse le contenu généré dès qu'il est disponible, ce qui améliore la réactivité des applications interactives.
Idéal pour
Créer des chatbots d'IA en temps réel
Créer des assistants de codage rapides
Développer des applications d'IA vocales
Exécuter des applications nécessitant des réponses à faible latence
OpenRouter
OpenRouter est une plateforme API qui connecte les développeurs à des modèles de plusieurs fournisseurs d'IA via un endpoint unique. Au lieu de gérer des intégrations distinctes pour différents services, les développeurs peuvent accéder à divers modèles avec une seule clé API. Elle facilite la comparaison des modèles et le changement de fournisseur. Cette flexibilité est utile pour tester différents modèles dans une même application.
Fonctionnalités clés
API unifiée : accédez aux modèles de plusieurs fournisseurs via un seul endpoint et une seule clé API.
Sélection des modèles : comparez et choisissez les modèles en fonction de leurs performances, fonctionnalités et tarifs.
Routage et basculement entre fournisseurs : prend en charge le routage entre fournisseurs et les options de basculement afin d'améliorer la fiabilité des requêtes lorsqu'un fournisseur rencontre des problèmes de disponibilité.
Suivi de l'utilisation : aide les développeurs à surveiller l'utilisation de l'API et les dépenses associées aux différents modèles.
Idéal pour
Comparer différents fournisseurs de LLM
Créer des applications utilisant plusieurs modèles
Tester des modèles avant de choisir un fournisseur
Gérer les intégrations d'API d'IA depuis une seule plateforme
Cloudflare Workers AI
Cloudflare Workers AI offre un accès serverless aux modèles d'IA via le réseau mondial de Cloudflare. Les développeurs peuvent exécuter des charges de travail d'inférence sans gérer d'infrastructure GPU dédiée et intégrer directement des capacités d'IA aux applications créées avec Cloudflare Workers. Son catalogue de modèles propose des options pour la génération de texte, les embeddings, la génération d'images et d'autres tâches d'IA.
Fonctionnalités clés
Inférence en périphérie : exécute les modèles d'IA pris en charge sur le réseau mondial de Cloudflare, rapprochant l'inférence des applications et des utilisateurs.
Déploiement serverless : exécute les charges de travail d'IA sans gérer de serveurs dédiés.
Plusieurs modèles d'IA : prend en charge des modèles de génération de texte, d'embeddings et de traitement d'images.
Intégration à Workers : relie l'inférence d'IA à la logique applicative serverless.
Idéal pour
Créer des applications d'IA serverless
Ajouter des fonctionnalités d'IA à des sites web existants
Créer des chatbots en périphérie
Développer des outils légers propulsés par l'IA
Mistral AI API
Mistral AI API permet aux développeurs d'accéder à des modèles de langage conçus pour la génération de texte, le raisonnement, le codage et d'autres tâches d'IA. Sa gamme de modèles comprend des options généralistes et spécialisées adaptées à différentes charges de travail. Les développeurs peuvent intégrer ces modèles dans leurs applications via des requêtes API. C'est également un choix utile pour les équipes qui recherchent des options de déploiement de modèles flexibles.
Fonctionnalités clés
Portefeuille de modèles polyvalent : propose des modèles pour les tâches linguistiques généralistes, le raisonnement, le codage et les charges de travail spécialisées.
Appel de fonctions : permet aux modèles d'interagir avec des outils et services externes.
Sorties JSON : prend en charge des réponses structurées pour les flux de travail applicatifs.
Embeddings : fournit des embeddings de texte pour les tâches de recherche, de récupération et de similarité sémantique.
Fonctionnalités d'Agent : fournit une API Agent avec des outils intégrés tels que la recherche web, l'exécution de code et des bibliothèques de documents, afin de créer des flux de travail d'IA plus performants.
Idéal pour
Créer des applications métier propulsées par l'IA
Créer des assistants de codage et de raisonnement
Développer des systèmes de génération augmentée par récupération (RAG)
Automatiser le traitement de texte et les flux de travail de contenu
Catalogue API NVIDIA et NIM
Le catalogue API NVIDIA et NIM offrent deux façons d'accéder à des services d'inférence d'IA optimisés par NVIDIA. Les développeurs peuvent utiliser les endpoints de modèles hébergés dans le catalogue API pour prototyper des applications, ou télécharger des conteneurs NIM afin de déployer des modèles pris en charge sur leur propre infrastructure GPU, y compris dans des environnements cloud et des centres de données.
Les coûts des licences logicielles et du calcul sont distincts. Les offres NIM actuelles incluent NIM et NIM Certified Feature Branch sans frais de licence logicielle, conformément aux conditions applicables.
Fonctionnalités clés
Inférence optimisée : utilise les logiciels NVIDIA et les technologies GPU pour optimiser les performances d’inférence sur le matériel pris en charge.
Conteneurs préconfigurés : fournit des microservices d’inférence préconfigurés pour les modèles d’IA pris en charge.
API standardisées : propose des interfaces API cohérentes pour intégrer les modèles déployés aux applications.
Déploiement flexible : prend en charge le déploiement dans le cloud, les centres de données et les postes de travail.
Idéal pour
Déployer des modèles d’IA sur une infrastructure GPU
Créer des applications d’IA d’entreprise
Exécuter des services d’inférence d’IA privés
Intégrer l’IA générative aux systèmes existants
API Cohere
L’API Cohere se concentre sur les modèles de langage et les outils conçus pour les applications métier et les flux de travail d’entreprise. Elle offre des fonctionnalités de génération de texte, de recherche sémantique, d’embeddings et de reranking. Ces fonctionnalités aident les développeurs à créer des systèmes de recherche d’entreprise et de génération augmentée par récupération (RAG), qui extraient des informations pertinentes dans de vastes collections de données métier. Cohere propose une clé d’évaluation gratuite, assortie d’un plafond mensuel et de limites de débit propres à chaque endpoint.
Fonctionnalités clés
Modèles Command : prennent en charge la génération de texte, le raisonnement et les tâches linguistiques orientées métier.
Modèles Embed : convertissent le texte et les entrées d’image prises en charge en représentations vectorielles pour la recherche sémantique et multimodale, selon le modèle sélectionné.
Modèles Rerank : améliorent les résultats de recherche en classant les documents selon leur pertinence.
Prise en charge de RAG : aide à relier les modèles de langage à des sources de connaissances externes.
Idéal pour
Créer des applications de recherche d’entreprise
Créer des systèmes de génération augmentée par récupération
Développer des outils de gestion des connaissances
Améliorer la recherche de documents et la récupération d’informations
API Together AI
Together AI offre un accès via API à un large éventail de modèles d’IA open source et à poids ouverts. Les développeurs peuvent utiliser sa plateforme pour la génération de texte et d’images, les embeddings et d’autres tâches d’inférence. Elle propose également des outils de fine-tuning et de déploiement de modèles. C’est donc une option flexible pour les développeurs qui souhaitent mieux maîtriser leur choix de modèles d’IA.
Fonctionnalités clés
Vaste catalogue de modèles à poids ouverts : donne accès à un large choix de modèles à poids ouverts pour différentes applications d’IA.
Inférence rapide : fournit une infrastructure optimisée pour exécuter des modèles d’IA.
Fine-tuning : permet aux développeurs de personnaliser les modèles pris en charge pour des tâches spécifiques.
Endpoints dédiés : propose des options de déploiement pour les applications ayant des exigences de performances spécifiques.
Idéal pour
Expérimenter avec des LLM open source
Affiner des modèles pour des applications spécifiques
Créer des chatbots d’IA personnalisés
Déployer des services d’IA générative évolutifs
Novita AI
Novita AI est une plateforme d’infrastructure d’IA qui offre un accès via API à divers modèles de langage et modèles d’IA générative. Les développeurs peuvent intégrer des capacités de LLM dans leurs applications via des services API hébergés, sans avoir à gérer leur propre infrastructure d’inférence. Outre l’accès aux modèles de langage, la plateforme propose également des API de génération d’images et de vidéos, pour les applications combinant une IA fondée sur le texte et la génération de contenu visuel.
Principales fonctionnalités
Accès aux modèles LLM : fournit un accès API à plusieurs modèles de langage pour la génération de texte, le raisonnement et d'autres tâches basées sur le langage.
API compatible avec OpenAI : prend en charge des interfaces compatibles permettant d'intégrer les modèles pris en charge dans des applications existantes.
Infrastructure d'inférence hébergée : fournit une inférence de modèles gérée, afin que les développeurs n'aient pas à exploiter leur propre infrastructure de mise à disposition des modèles.
API supplémentaires d'IA générative : propose des modèles de génération d'images et de vidéos en complément de ses services LLM.
Idéal pour
Créer des chatbots IA et des assistants conversationnels
Développer des assistants de programmation et d'autres outils basés sur des LLM
Intégrer des modèles de langage dans des applications existantes
Créer des plateformes d'IA combinant génération de texte, d'images et de vidéos
Quelle API LLM utiliser ?
Commencez par choisir le modèle d'accès adapté à votre budget. Pour un prototype sans achat initial de crédits, comparez les modèles Gemini éligibles, l'offre gratuite de Groq, les variantes gratuites d'OpenRouter et l'allocation quotidienne de Cloudflare. Les clés d'évaluation de Cohere et le catalogue hébergé de NVIDIA sont utiles pour effectuer des tests dans le cadre de leurs conditions d'évaluation ou de prototypage. Kimi, Mistral et Together nécessitent un accès API payant ; l'ancienne offre promotionnelle de parrainage de Novita a pris fin. Comparez ensuite les candidats sur vos propres tâches à l'aide des critères ci-dessous.
Capacités des modèles : choisissez une API offrant les capacités dont votre application a besoin, comme le raisonnement, la programmation, la génération de texte ou le traitement multimodal.
Limites d'utilisation gratuite : vérifiez le nombre de requêtes gratuites, les quotas de token, les limites de débit et l'éventuelle expiration des crédits gratuits.
Compatibilité API : recherchez des points de terminaison compatibles avec OpenAI et la prise en charge de SDK afin de simplifier l'intégration aux applications existantes.
Vitesse de réponse : tenez compte de la vitesse d'inférence et de la latence, en particulier pour créer des chatbots en temps réel ou des applications interactives.
Fenêtre de contexte : vérifiez les limites maximales de token en entrée et en sortie si votre application traite des documents longs ou des conversations complexes.
Documentation et assistance aux développeurs : choisissez des fournisseurs proposant une documentation API claire, des exemples de code, des SDK et des ressources de dépannage.
Évolutivité et coût total : estimez l'utilisation en entrée, en sortie et pour le raisonnement, les frais de cache, les outils payants, les frais de plateforme et tout achat minimal. Pour NIM auto-hébergé, incluez les coûts de GPU et d'exploitation. Comparez une charge de travail complète plutôt que le tarif de token le plus bas annoncé par un fournisseur.
Conclusion
La bonne API peut rendre le développement d'IA plus simple, plus flexible et plus abordable. Avec autant d'API LLM gratuites et payantes pour les développeurs, vous disposez de nombreuses options pour expérimenter et créer quelque chose d'utile. Commencez par les fonctionnalités les plus importantes pour votre projet et testez différents modèles avant de prendre une décision. Vous pouvez également essayer la Kimi API pour explorer ses capacités de raisonnement et de programmation.




