
Les grands modèles de langage peuvent aider les applications à répondre à des questions, résumer des documents, générer du contenu et assister la programmation. Une API de LLM offre aux développeurs un accès programmatique à ces capacités afin de les intégrer à leurs flux de travail logiciels. Ce guide explique le fonctionnement des API de LLM, les critères à prendre en compte pour en choisir une et comment Kimi API peut prendre en charge votre application.
Qu'est-ce qu'une API de LLM ?
Une API de LLM (API de grand modèle de langage) est une interface qui permet aux applications d'accéder par programmation aux capacités de grands modèles de langage. Elle sert de passerelle entre une application et un modèle d'IA, permettant aux développeurs d'envoyer des prompts, de configurer les paramètres pris en charge et de recevoir les réponses générées par le modèle.
Par exemple, une plateforme de support client peut utiliser une API de LLM pour répondre aux questions des clients, tandis qu'un système de gestion de contenu peut l'intégrer pour résumer des articles ou générer des descriptions de produits.
Selon le modèle, une API de LLM peut prendre en charge la génération de texte, les questions-réponses, la synthèse, la traduction, la génération de code, l'analyse de documents et les conversations à plusieurs tours. Certains services prennent également en charge des entrées multimodales, comme les images. Une clé API de LLM authentifie les requêtes adressées au service du fournisseur.
Concepts fondamentaux d'une API de LLM
Lorsque vous utilisez une API de LLM, vous rencontrez quatre notions de base : les requêtes, les réponses, les points de terminaison et l'authentification. Comprendre leur fonctionnement vous aide à démarrer l'intégration de l'API.
Une passerelle d'API de LLM se place entre une application et les services de modèles et peut offrir des fonctionnalités telles que le routage, la journalisation, la limitation du débit, la mise en cache et le repli.
Requête : une requête est le message que votre application envoie au service de LLM. Elle contient généralement un prompt ainsi que des paramètres qui contrôlent la manière dont le modèle génère sa réponse, comme le choix du modèle ou la longueur maximale de sortie.
Réponse : une réponse est l'ensemble des données renvoyées par le service de LLM après le traitement d'une requête. Elle comprend généralement le texte généré, ainsi que des informations telles que l'état de la requête, l'utilisation des token ou d'autres métadonnées.
Point de terminaison : un point de terminaison est l'URL précise à laquelle votre application envoie des requêtes API. Les fournisseurs de LLM peuvent proposer différents points de terminaison pour des tâches telles que la génération de texte, les embeddings ou d'autres capacités du modèle.
Authentification : l'authentification vérifie que votre application est autorisée à accéder à l'API. La plupart des services de LLM utilisent une clé API, un identifiant unique qui identifie votre application et aide le fournisseur à gérer les accès et à suivre l'utilisation. Cette clé s'obtient généralement via la plateforme de développement du fournisseur.
Ces quatre notions fonctionnent ensemble dans une interaction API classique : votre application s'authentifie avec une clé API, envoie une requête au point de terminaison approprié et reçoit une réponse du service de LLM. Ce processus de base constitue le fondement de l'intégration des modèles de langage dans les applications.
Comment fonctionne une API de LLM ?
Une API de LLM connecte une application à un modèle de langage via un processus de requête-réponse. L'application envoie des données à un point de terminaison de l'API, le modèle traite la requête, puis l'API renvoie la réponse générée.
Le processus comporte généralement cinq étapes :
Obtenir l'accès à l'API : inscrivez-vous auprès d'un fournisseur d'API et générez une clé API. Cette clé authentifie les requêtes et doit être stockée de manière sécurisée côté serveur.
Préparer et envoyer une requête : l'application envoie une requête au point de terminaison de l'API, généralement à l'aide de HTTP et de JSON. Elle comprend habituellement le modèle sélectionné, le prompt utilisateur ou les messages de la conversation, ainsi que des paramètres facultatifs tels que la température et le nombre maximal de token en sortie.
Traiter les données d'entrée : l'API valide la requête et la transmet au LLM sélectionné. Le modèle interprète le prompt et utilise le contexte fourni pour générer une réponse pertinente.
Générer et renvoyer la réponse : l'API renvoie la sortie du modèle, généralement au format JSON. Les réponses peuvent être fournies en une seule fois ou diffusées progressivement à mesure que le modèle génère le contenu.
Utiliser la sortie : l'application extrait le contenu généré et l'utilise selon son objectif, par exemple pour afficher les réponses d'un chatbot, résumer des documents ou stocker des informations extraites.
Pourquoi utiliser une API de LLM ?
Une API de LLM offre aux développeurs un moyen cohérent de connecter des modèles de langage aux flux de travail de leurs applications, ce qui facilite la création de fonctionnalités telles que des chatbots, des outils de synthèse et des assistants de programmation.
Intégrer l’IA aux applications existantes : Connectez des modèles de langage à des sites web, des applications mobiles et des systèmes d’entreprise pour ajouter des fonctionnalités telles que des chatbots, la recherche intelligente et la génération de contenu.
Automatiser les tâches répétitives : Automatisez des tâches telles que la réponse aux questions fréquentes, la synthèse de documents, l’extraction d’informations et la classification des retours clients.
Personnaliser les interactions avec l’IA : Utilisez des prompts, du contexte et des paramètres de génération pour contrôler le ton, le format et le contenu des réponses en fonction des exigences de l’application.
Accompagner l’évolution des applications : Intégrez des capacités d’IA à différents flux de travail et ajustez l’utilisation de l’API à mesure que les besoins de l’application évoluent, dans la limite des capacités et restrictions du fournisseur.
Réduire les besoins en infrastructure : Accédez à des modèles de langage hébergés sans gérer l’entraînement des modèles, le matériel spécialisé ni l’infrastructure d’inférence sous-jacente.
Accédez aux capacités des LLM pour vos applications : Kimi API
Si vous recherchez une API de LLM pour intégrer des capacités de modèles de langage à votre application, Kimi API propose une plateforme destinée aux développeurs, fondée sur les grands modèles de langage développés par Moonshot AI. Elle offre des options flexibles pour créer facilement des outils, applications et flux de travail alimentés par l’IA.
Elle propose un éventail de capacités pour créer des applications alimentées par l’IA, notamment la génération de texte, les conversations à plusieurs tours, l’analyse de fichiers et la recherche web. La plateforme prend également en charge le format OpenAI API, ce qui aide les développeurs à intégrer les modèles Kimi à des applications existantes avec moins d’efforts de migration.
Fonctionnalités clés
Plusieurs modèles pour différents besoins de développement : Kimi API propose plusieurs modèles de langage aux capacités et profils de performance variés, ce qui permet aux développeurs de choisir selon les exigences de leur application. Qu’ils créent des assistants IA, des outils de programmation ou des applications de traitement de documents, ils peuvent sélectionner un modèle adapté à leurs charges de travail. Par exemple, kimi-k3-1-pro prend en charge le raisonnement complexe, la programmation à long horizon et le travail de connaissance.
Traitement de contextes longs pour les tâches complexes : kimi-k3-1-pro prend en charge une fenêtre de contexte de l’ordre du million de tokens, permettant aux applications de traiter des documents volumineux, de longues conversations et de grands volumes d’informations de référence. Cette capacité est utile pour l’analyse de documents, les flux de travail à forte intensité de connaissances et les tâches nécessitant de conserver le contexte sur plusieurs étapes.
Compatibilité avec le format OpenAI API : Kimi API prend en charge le format OpenAI API, ce qui facilite l’intégration des modèles Kimi aux applications existantes. Les développeurs habitués aux structures de requêtes compatibles avec OpenAI peuvent adapter leurs intégrations d’API existantes en modifiant moins de code, tout en vérifiant les paramètres et la prise en charge des fonctionnalités propres à chaque modèle.
Réponses en streaming et hors streaming : Kimi API prend en charge les réponses en streaming et hors streaming via son interface Chat Completions. Le streaming diffuse progressivement le contenu généré, ce qui le rend adapté aux applications interactives telles que les chatbots. Le mode hors streaming renvoie la réponse complète en une seule fois, ce qui convient aux tâches telles que la génération de contenu et la synthèse de documents.
Tarification à l’usage et mise en cache du contexte : Kimi API applique une tarification à l’usage, les frais d’inférence variant selon le modèle et incluant les tokens en entrée, les tokens en sortie et les éventuels frais d’écriture dans le cache. La mise en cache du contexte peut réduire les coûts d’entrée lorsque des préfixes de requête répétés sont réutilisés pendant la période de validité du cache. Les économies réelles dépendent du volume de contenu répété, des accès au cache et de la durée du cache. La recherche web et d’autres outils peuvent entraîner des frais distincts. Consultez la documentation officielle sur les tarifs pour connaître les tarifs et les modalités de facturation en vigueur.
Comment obtenir une clé Kimi API
Prendre en main Kimi API est simple : la première chose dont vous avez besoin est une clé API pour connecter votre application aux modèles de Moonshot AI. Suivez les étapes ci-dessous pour créer votre compte et obtenir votre clé Kimi API :
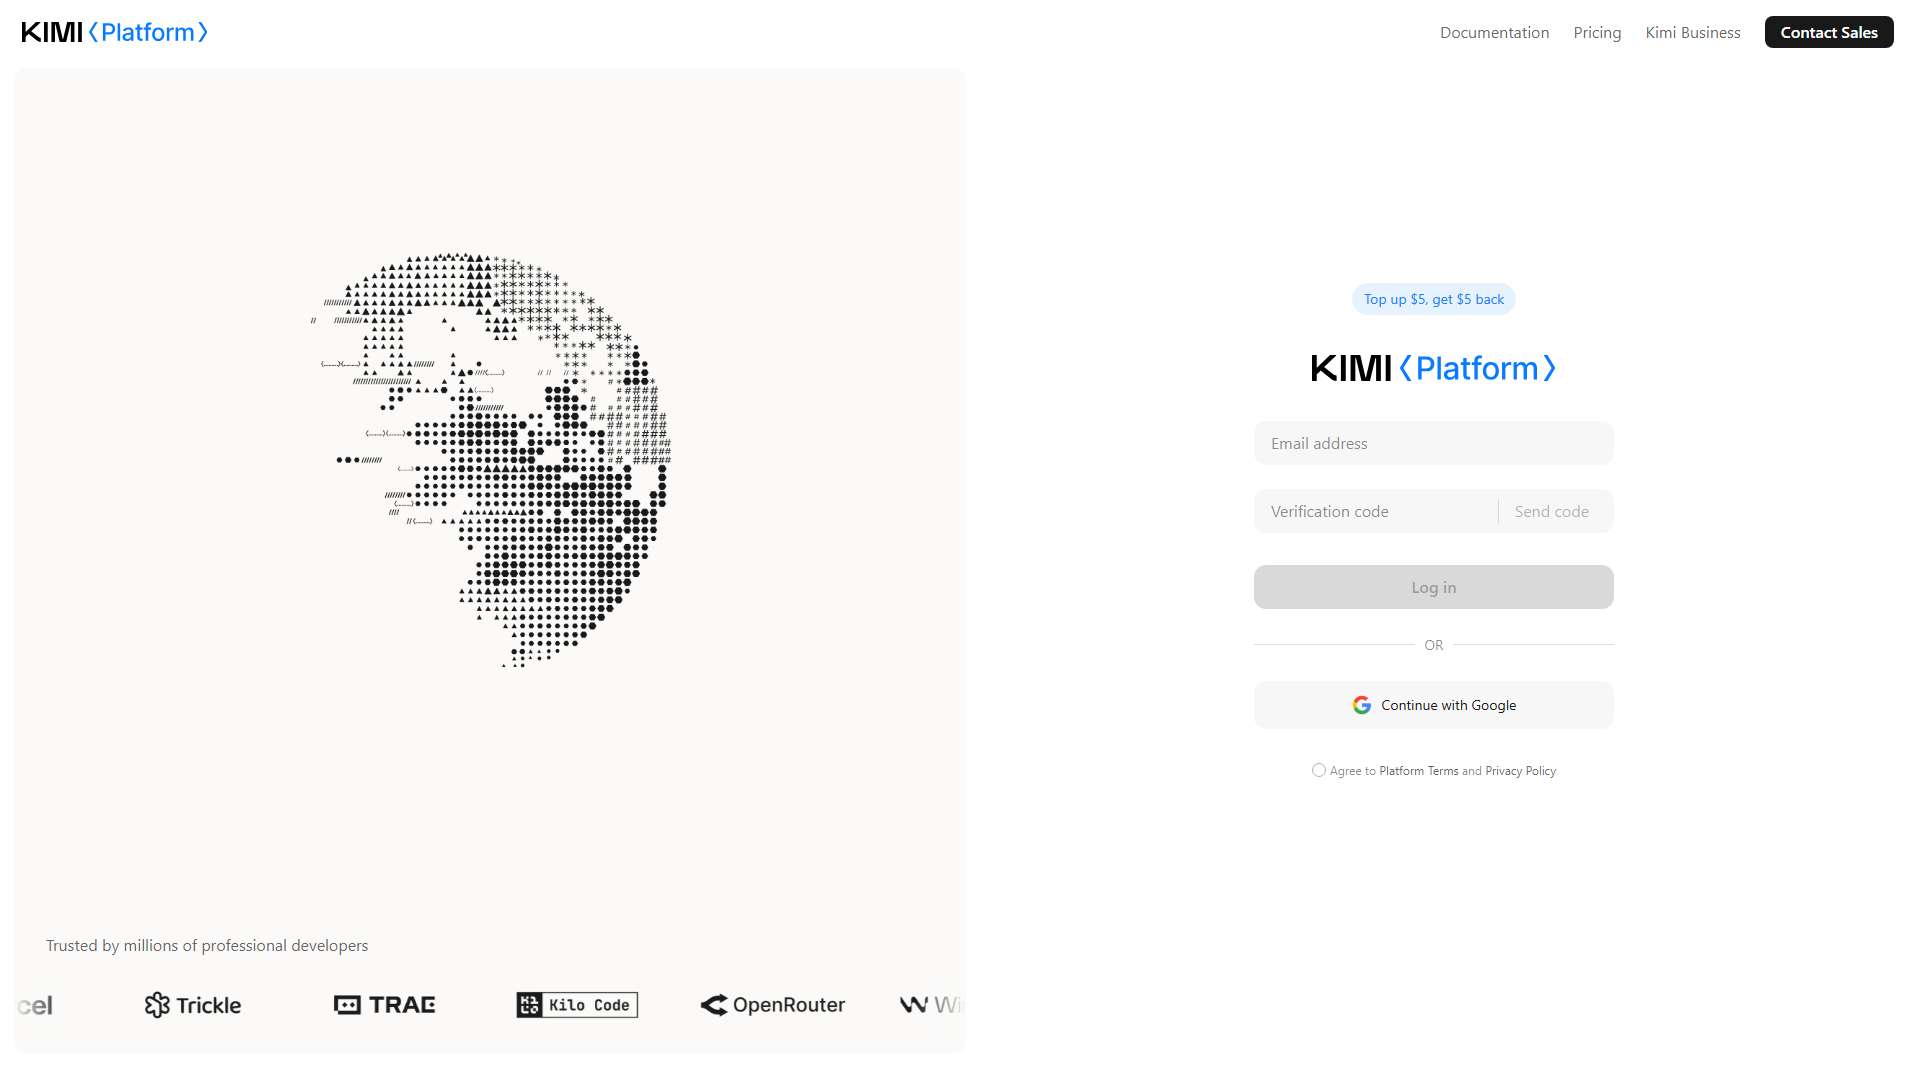
Étape 1 : Créez un compte développeur
Rendez-vous sur la plateforme Kimi API et créez un compte développeur. Connectez-vous pour accéder à la console API, où vous pouvez gérer vos clés API, votre utilisation et votre facturation.
Étape 2 : Générez une clé API
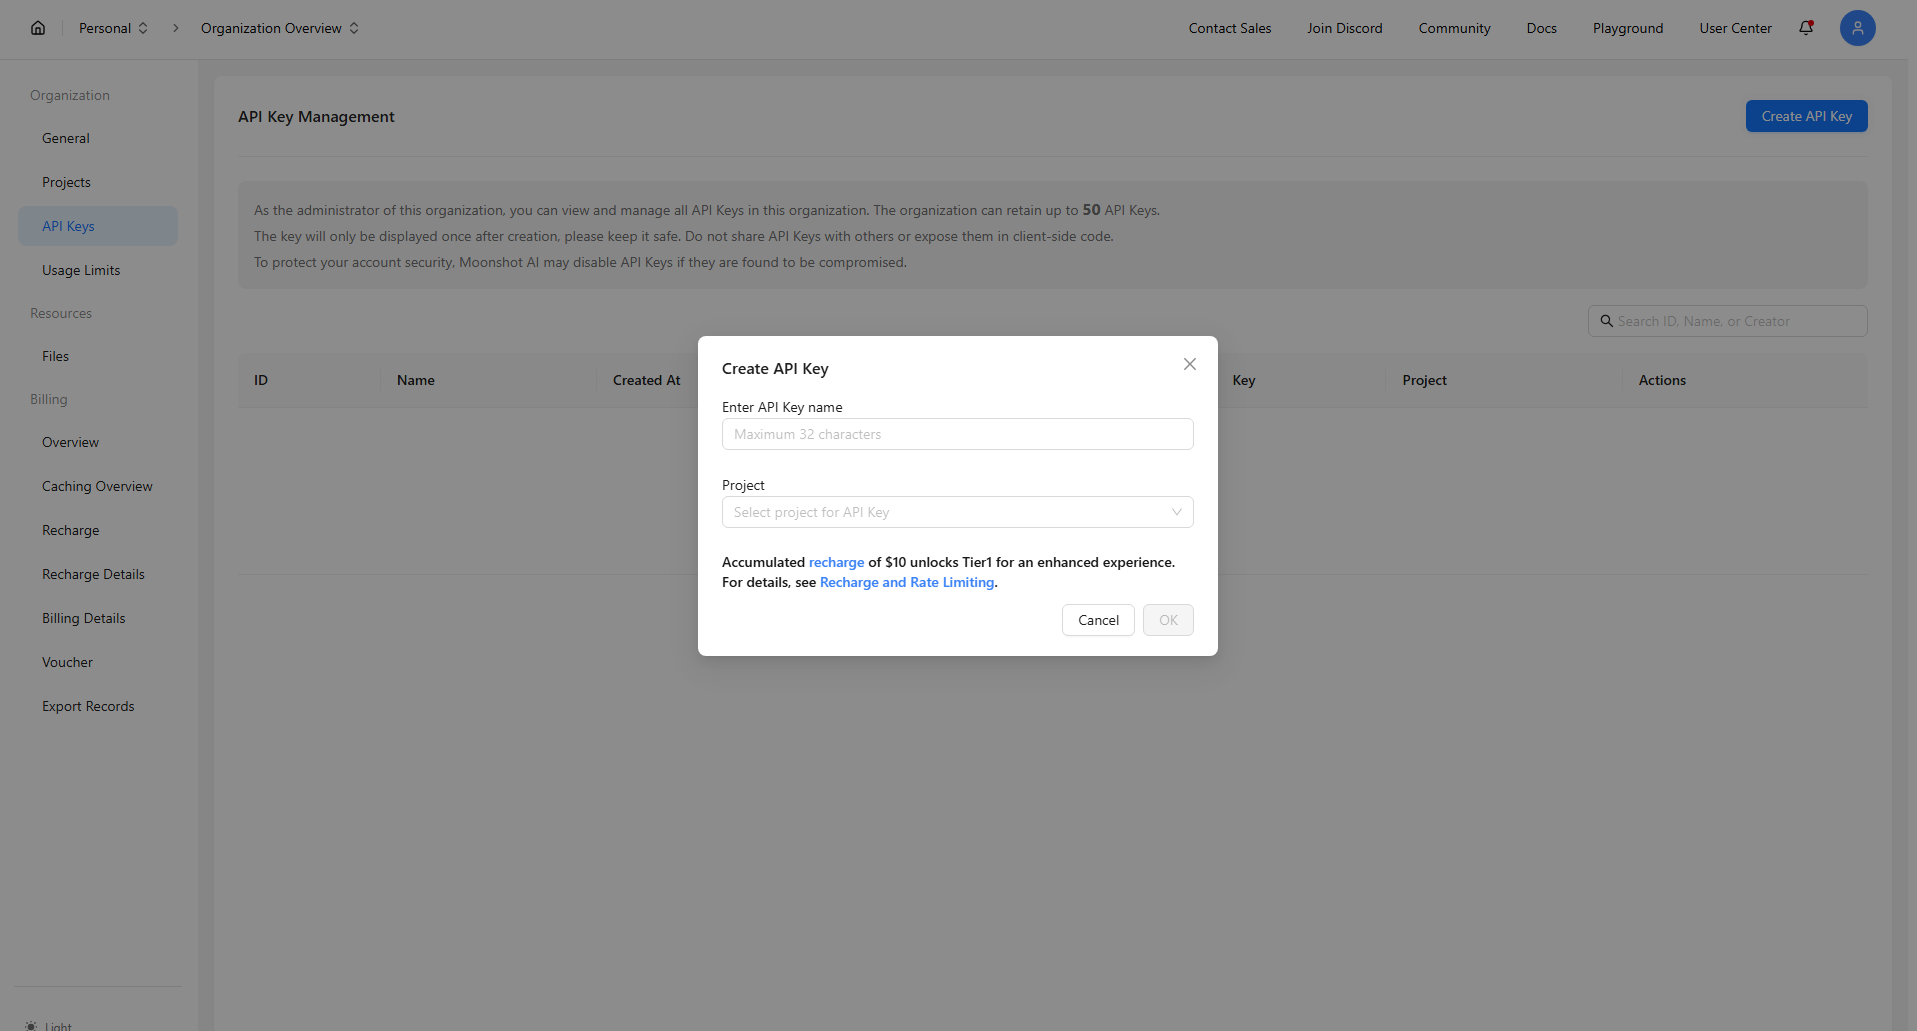
Ouvrez la section de gestion des clés API dans la console et cliquez sur « Create API Key ». Saisissez un nom pour identifier votre clé, confirmez sa création, puis copiez la clé générée. Conservez-la en lieu sûr, car vous ne pourrez peut-être plus afficher la clé complète par la suite.
Protégez votre clé API. Stockez-la dans une variable d’environnement côté serveur ou dans un gestionnaire de secrets, et ne l’exposez jamais dans des dépôts publics ou du code côté client.
Étape 3 : Préparez votre configuration API
Avant d’effectuer un appel API, préparez les éléments suivants :
Clé API : La clé générée à l’étape 2.
URL de base :
https://api.moonshot.ai/v1Modèle : L’ID du modèle Kimi que vous souhaitez utiliser.
Kimi API prend en charge le format Chat Completions compatible avec OpenAI ; vous pouvez donc utiliser des SDK compatibles pour envoyer des requêtes.
Étape 4 : Effectuez votre premier appel API
Installez le SDK Python OpenAI :
Définissez votre clé Kimi API comme variable d’environnement KIMI_API_KEY. Par exemple, utilisez la commande suivante dans votre terminal :
Pour macOS ou Linux
Pour Windows PowerShell
Créez ensuite un script Python nommé first_kimi_call.py contenant le code suivant :
Remplacez kimi-k3-1-pro par un ID de modèle Kimi valide. Exécutez ensuite le script :
Le script envoie une requête de complétion de conversation à Kimi API. Si la requête aboutit et renvoie une réponse, votre intégration de Kimi API fonctionne. Vous pouvez désormais modifier le prompt, changer de modèle et intégrer à votre application des fonctionnalités alimentées par l’API.
Critères de choix d’un fournisseur d’API de LLM unifiée
Un fournisseur d’API de LLM unifiée peut simplifier l’intégration de modèles en proposant une interface cohérente pour accéder aux modèles d’IA. Toutefois, la compatibilité API ne suffit pas à déterminer si un fournisseur convient à votre application. Lors de l’évaluation d’un fournisseur d’API de LLM, tenez compte des facteurs suivants :
Compatibilité avec le SDK OpenAI : Une interface compatible avec OpenAI permet aux développeurs de réutiliser des SDK et des schémas d'intégration familiers en configurant le point de terminaison API et l'ID du modèle du fournisseur. Vérifiez les points de terminaison, paramètres et fonctionnalités pris en charge afin de comprendre l'étendue de cette compatibilité.
Couverture des modèles et des fournisseurs : Tenez compte de la gamme de modèles et de fournisseurs disponibles. Un choix de modèles plus vaste offre aux développeurs davantage de souplesse pour tester différentes capacités, comparer les performances et sélectionner des modèles adaptés à des charges de travail spécifiques.
Visibilité sur l'utilisation et les coûts : Recherchez des moyens de surveiller les requêtes API, la consommation de token et les coûts d'utilisation. Un suivi par modèle ou par requête peut aider les développeurs à comprendre les tendances de dépenses et à gérer les budgets de leurs applications.
Mise en cache et performances : La mise en cache des réponses peut réduire les requêtes répétées et améliorer les temps de réponse pour les entrées récurrentes. Tenez également compte de la prise en charge du streaming, de la latence et des limites de débit lors de l'évaluation des performances de l'API.
Fiabilité et options de repli : Vérifiez comment le fournisseur gère les erreurs, les interruptions temporaires de service et les limites de débit. Les mécanismes de nouvelle tentative et les options de repli peuvent contribuer à maintenir la disponibilité de l'application lorsqu'un modèle ou un point de terminaison devient indisponible.
Observabilité et contrôle du déploiement : Les journaux de requêtes, les métriques de performance et le traçage peuvent aider les développeurs à résoudre les problèmes liés à l'API et à évaluer le comportement des modèles. Pour les applications ayant des exigences particulières en matière d'infrastructure ou de données, tenez également compte des options de déploiement et des politiques de gestion des données.
Le choix du bon fournisseur dépend des exigences techniques de votre application, de l'utilisation prévue et de vos priorités opérationnelles. Pour les développeurs qui prévoient déjà d'utiliser les modèles Kimi, Kimi API propose une interface compatible avec OpenAI pour intégrer les modèles pris en charge aux applications existantes. Configurez le point de terminaison API et l'ID du modèle pour commencer.
Cas d'usage courants des API LLM
Les API LLM prennent en charge un large éventail d'applications en permettant aux logiciels de comprendre, générer et traiter le langage naturel. Parmi les cas d'usage courants :
Chatbots IA et assistance client : Intégrez des LLM aux chatbots afin de comprendre les questions des clients et de générer des réponses pertinentes. Les entreprises peuvent les utiliser pour répondre aux questions fréquentes, fournir des informations sur les produits, aider au dépannage et traiter les demandes des clients.
Génération de contenu et aide à la rédaction : Utilisez les API LLM pour générer des descriptions de produits, des textes marketing, des campagnes par e-mail et des publications sur les réseaux sociaux. Les applications d'écriture peuvent également les intégrer pour reformuler des paragraphes, corriger la grammaire, ajuster le ton et résumer des contenus longs.
Traitement de documents et extraction de données : Traitez les informations non structurées issues de contrats, de rapports et de documents professionnels. Les API LLM peuvent aider à extraire les informations clés, repérer les clauses importantes, catégoriser le contenu et générer des synthèses concises, réduisant ainsi la révision manuelle des documents.
Assistants de programmation IA : Intégrez des modèles de langage aux outils de développement pour générer du code à partir d'instructions en langage naturel, expliquer le code existant, identifier d'éventuels bugs et suggérer des correctifs. Ils peuvent également aider à rédiger des tests unitaires et de la documentation technique.
Recherche sémantique et récupération de connaissances : Créez des applications de recherche qui comprennent le sens et le contexte des requêtes des utilisateurs, au lieu de s'appuyer uniquement sur les correspondances exactes de mots-clés. Associées à des embeddings et à des systèmes de récupération, les API LLM peuvent aider les utilisateurs à trouver des informations pertinentes parmi les documents et bases de connaissances de l'entreprise.
Traduction et localisation : Intégrez les API LLM aux flux de traduction afin de traiter le contenu de sites web, les descriptions de produits et les communications professionnelles dans plusieurs langues. Des instructions contextuelles et des directives terminologiques peuvent aider à maintenir une communication cohérente sur différents marchés.
Conclusion
Le choix de la bonne API LLM dépend des besoins de votre application, de la complexité de vos tâches et de votre budget. Une bonne API doit faciliter l'intégration de l'IA tout en vous offrant assez de souplesse pour développer et améliorer votre application au fil du temps. Kimi API mérite d'être explorée si vous recherchez une plateforme flexible proposant différents modèles et des fonctionnalités adaptées aux développeurs.




